ORPHEUS erreicht Werte der Spitzenklasse auf zwei öffentlichen medizinischen Benchmarks
Philipp Mühl
Product & Policy Strategy, IDM gGmbH
Stand der Messungen: 28. September 2026
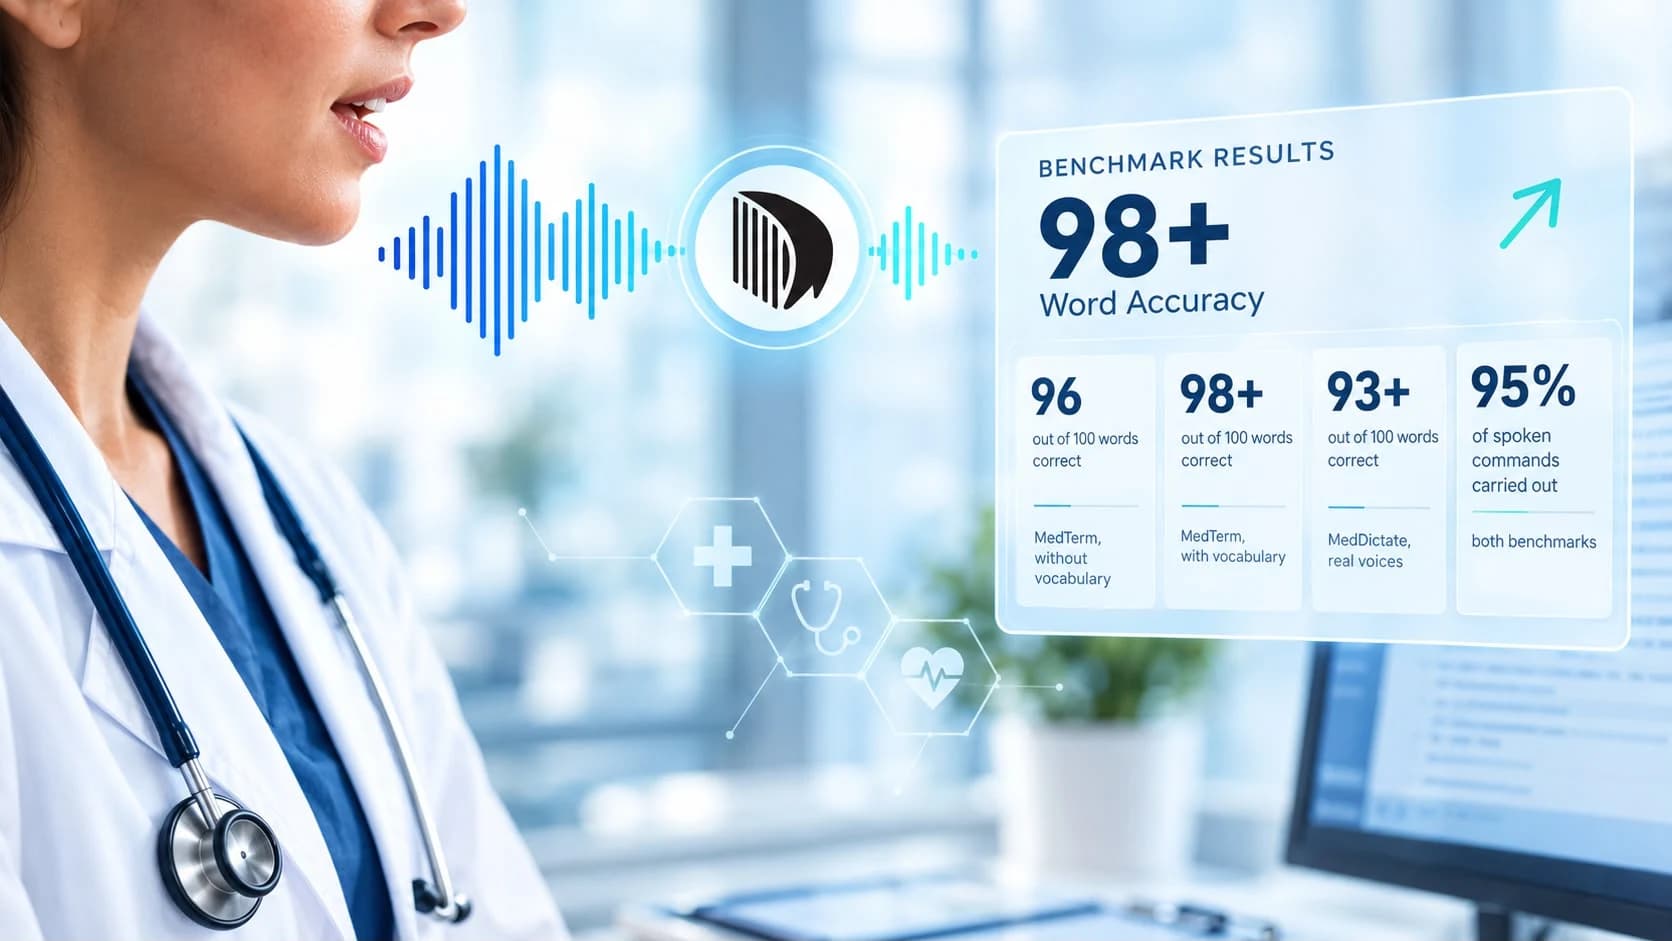
- von 100 Wörtern korrekt
- 96
- MedTerm, ohne Vokabular
- von 100 Wörtern korrekt
- 98+
- MedTerm, mit Vokabular
- von 100 Wörtern korrekt
- 93+
- MedDictate, echte Stimmen
- der gesprochenen Befehle umgesetzt
- 95 %
- beide Benchmarks
Medizinische Spracherkennung muss im klinischen Alltag vor allem eines leisten: Gesprochene Sprache, komplexe Fachbegriffe, Zahlen und Dosierungen zuverlässig in verwendbaren Text übersetzen. Auf MedTerm, einem öffentlichen Benchmark, der mit 200 synthetischen klinischen Diktaten genau diese Anforderungen nachstellt, erkennt ORPHEUS 96 von 100 diktierten Wörtern korrekt. Sind die schwierigsten Fachbegriffe vorab im Vokabular hinterlegt, steigt dieser Anteil auf mehr als 98 von 100 Wörtern; die hinterlegten Fachbegriffe selbst schreibt ORPHEUS dann ebenfalls zu 98 Prozent exakt richtig.
Auch mit echten Stimmen bleibt die Erkennung hoch, und gesprochene Befehle setzt ORPHEUS zuverlässig um. Auf MedDictate, einem zweiten Benchmark mit echten statt synthetischen Stimmen, die mit wechselndem Tempo, individueller Aussprache und Pausen anspruchsvoller sind, erkennt ORPHEUS mehr als 93 von 100 Wörtern korrekt. Befehle wie „Punkt“ oder „neue Zeile“, mit denen Ärztinnen und Ärzte ihren Text beim Diktieren gliedern, setzt ORPHEUS auf beiden Benchmarks zu 95 Prozent um.
Die Ergebnisse zeigen: ORPHEUS verbindet eine niedrige Wortfehlerrate mit zuverlässiger Erkennung medizinischer Fachbegriffe und gesprochener Formatierungsbefehle. Damit entsteht aus gesprochener Sprache nicht nur eine Transkription, sondern ein direkt nutzbarer medizinischer Text, mit wenigen Korrekturen, strukturierten Befunden und der Möglichkeit, die Erkennung gezielt an die Fachsprache einer Einrichtung anzupassen.
Beide Benchmarks hat das dänische Medizin-KI-Unternehmen Corti veröffentlicht, und wir haben mit dessen offenem Auswertungswerkzeug gemessen [3]. Wer tiefer einsteigen will, findet alle Details im technischen Bericht von Dr. Jan Brederecke, der bei uns das Modelltraining für ORPHEUS verantwortet, und Leo Harmsen, dem Teamleiter des ORPHEUS-Teams: Aufbau der Datensätze und Messmethode, die zentralen Kennzahlen mit ihrer statistischen Unsicherheit, die vollständigen Vergleichswerte weiterer Systeme sowie eine ausführliche Diskussion der Zählweisen und der Grenzen der Messung.
Technischer Bericht
Wie gut versteht ORPHEUS medizinisches Diktat? Wir haben es getestet
Jan Brederecke, Leo Harmsen
Wie wir ORPHEUS auf den öffentlichen Datensätzen MedTerm und MedDictate gemessen haben: Methode, Zählweisen, alle Kennzahlen mit Konfidenzintervallen, Vergleichswerte und Limitationen.
Zum technischen Bericht
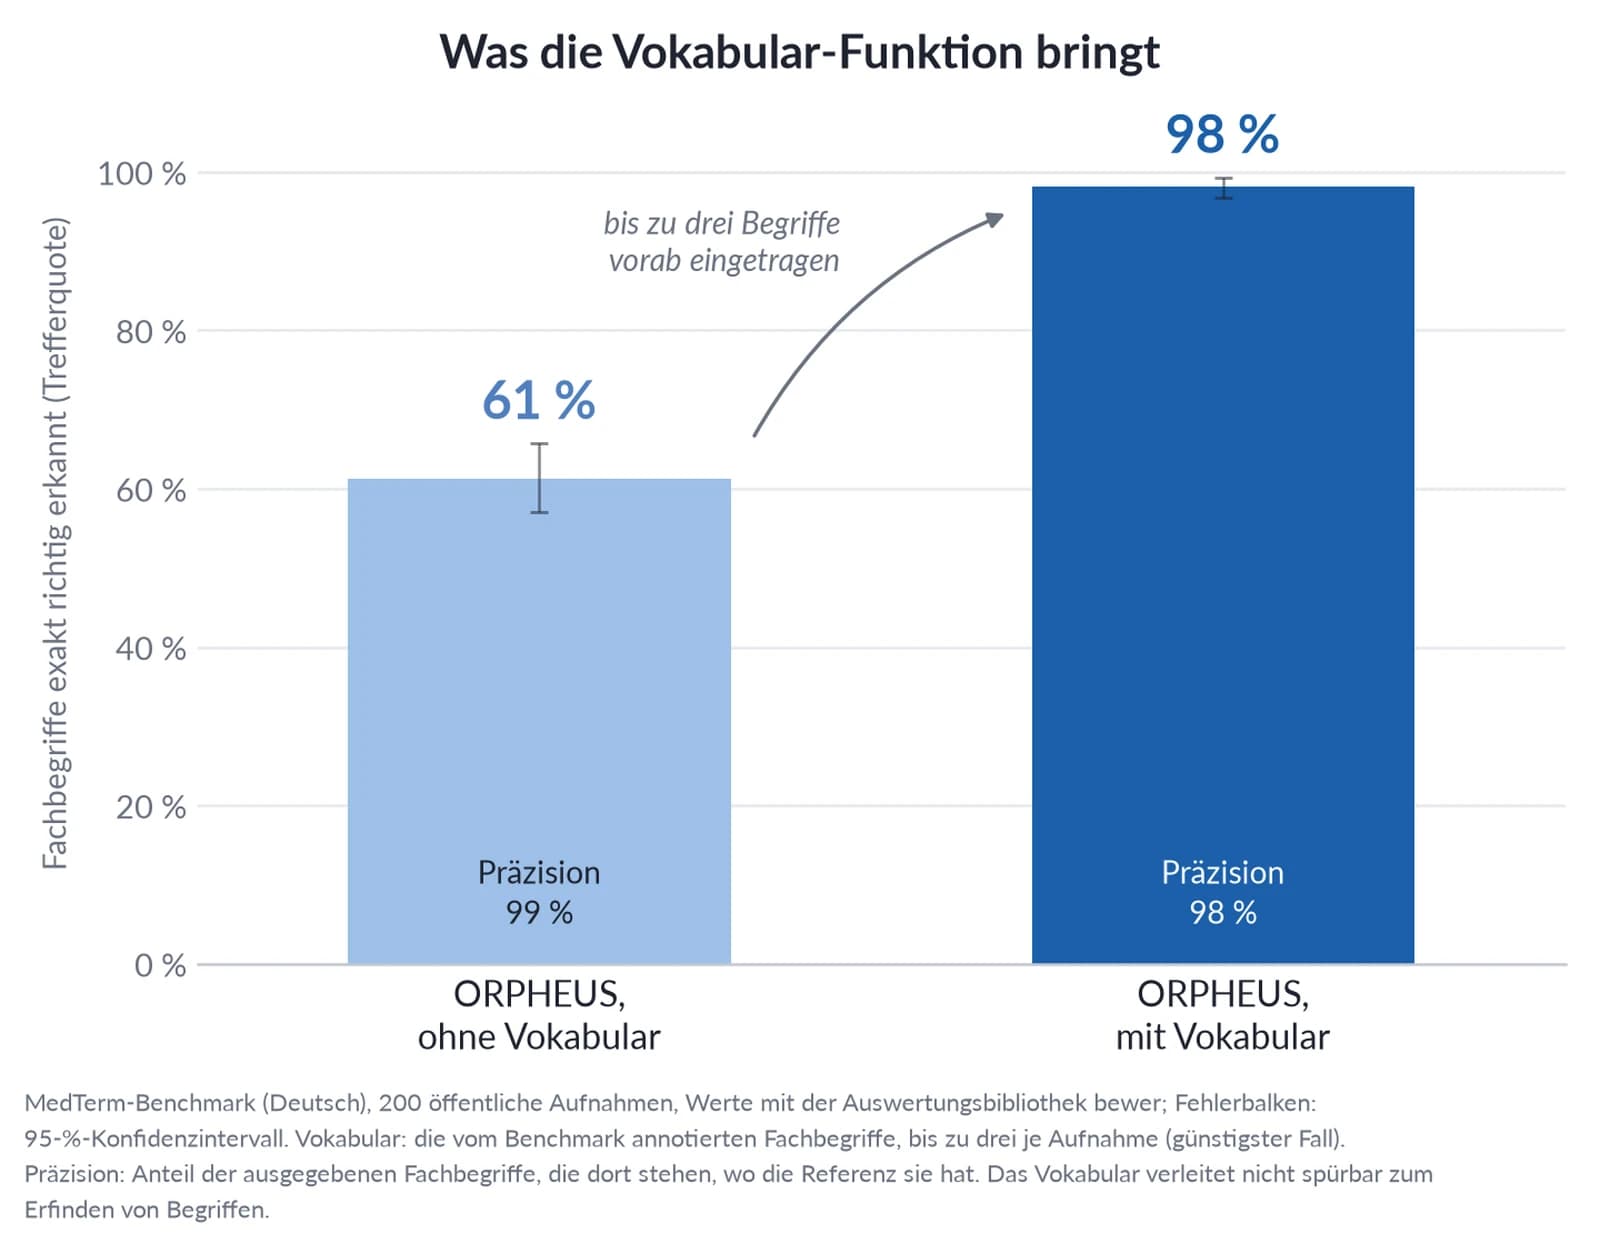
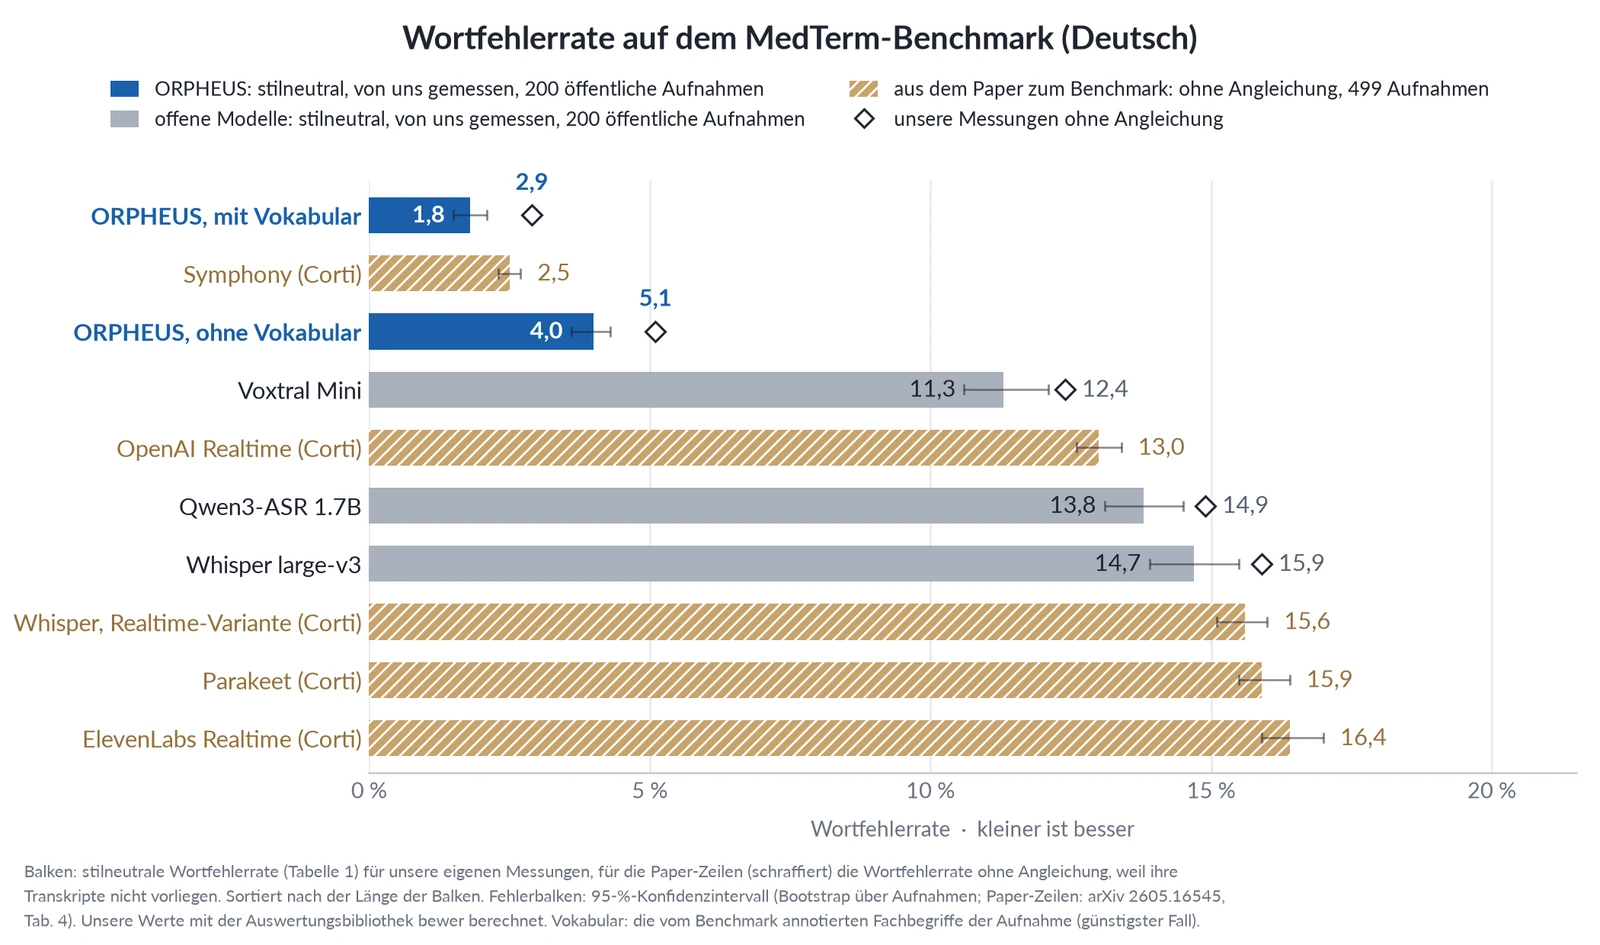
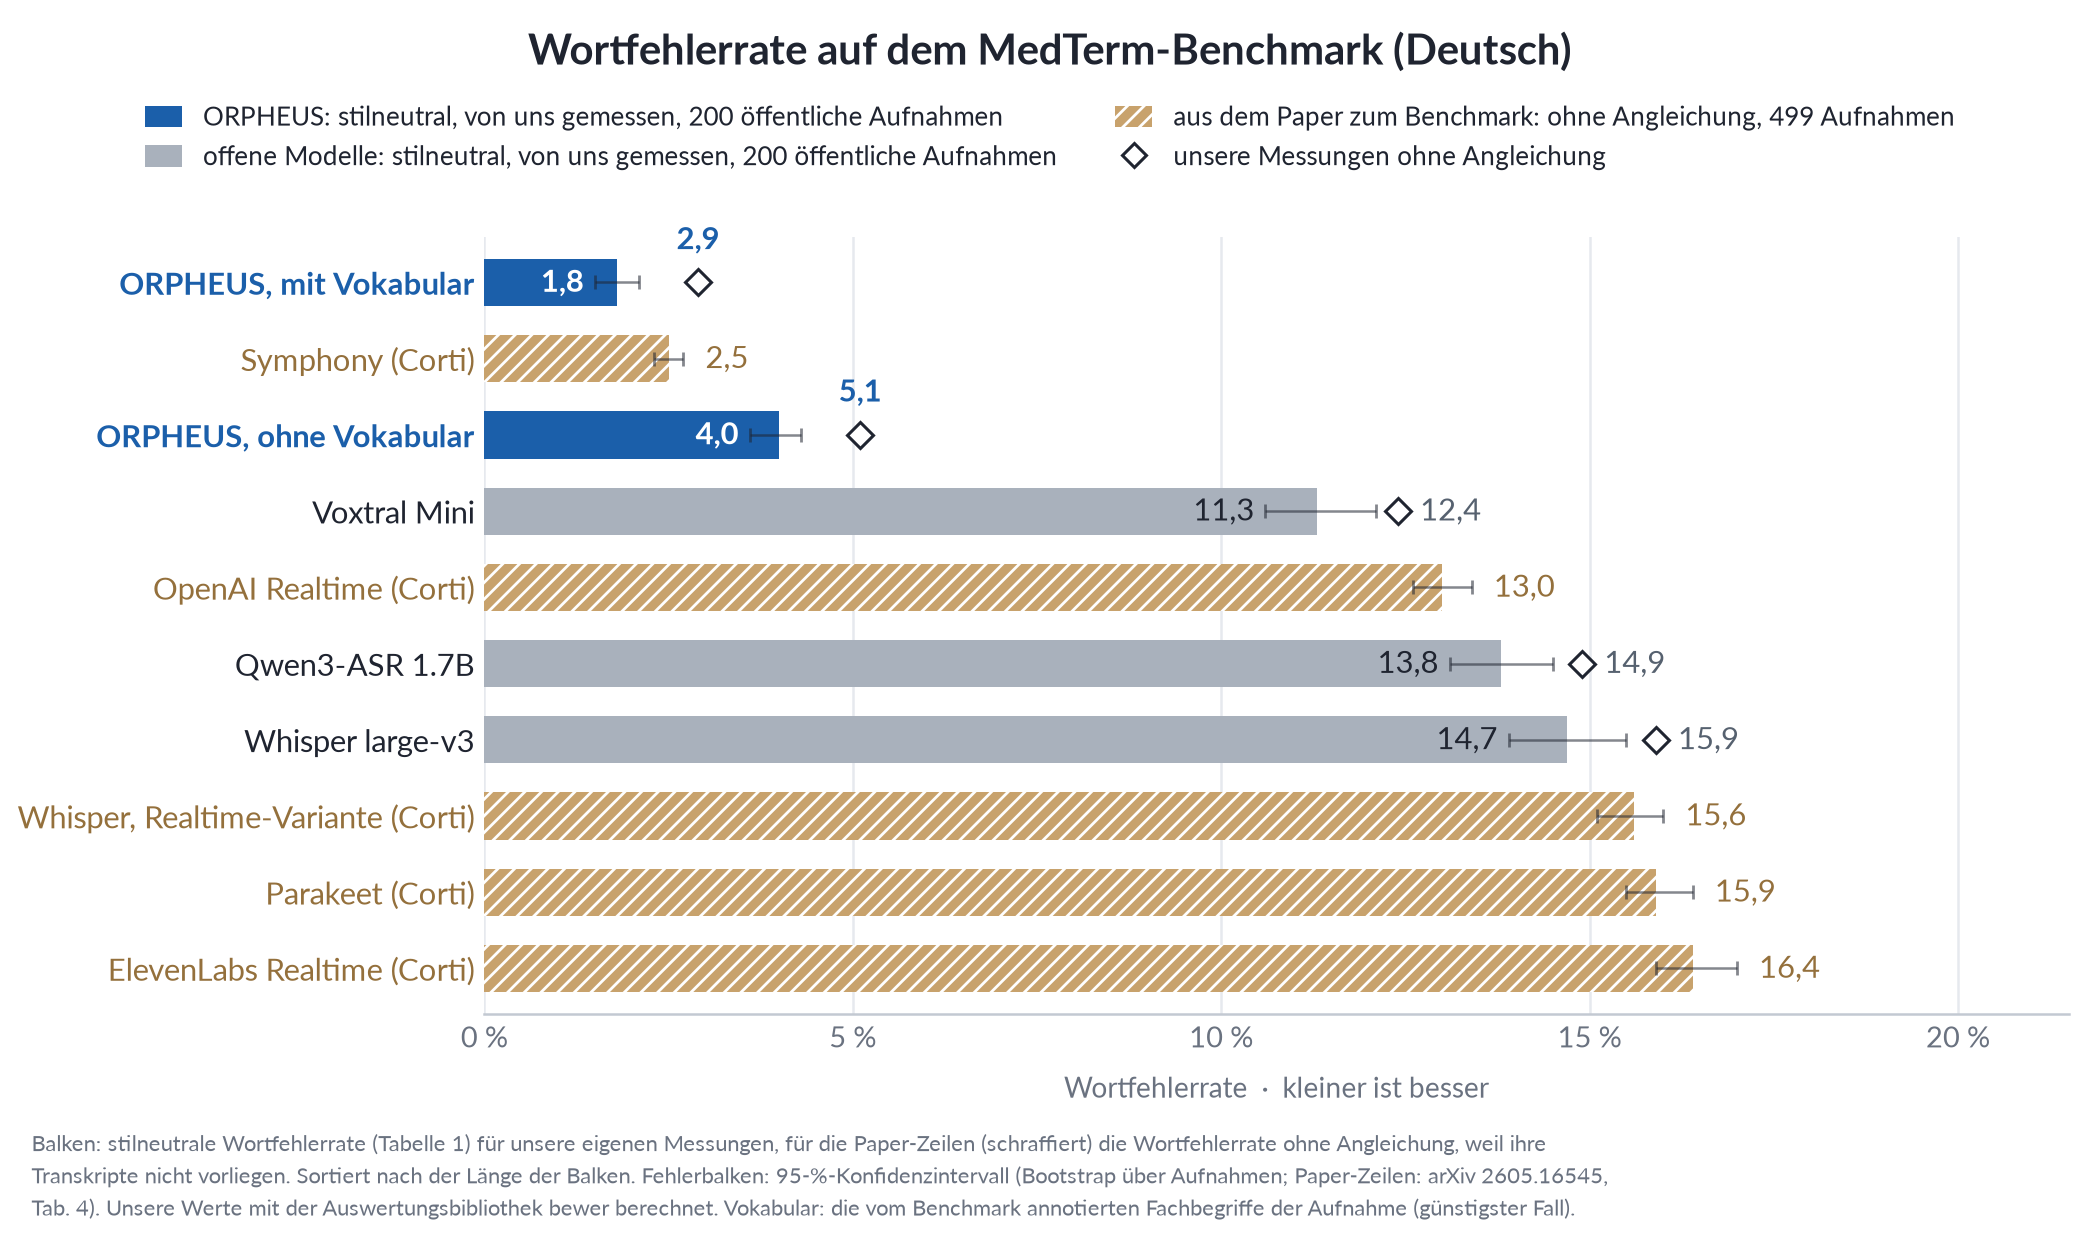
Abbildung 1: Wortfehlerrate auf dem öffentlichen Benchmark MedTerm, deutscher Teil; kleiner ist besser. Die Grafik zeigt ORPHEUS neben den Systemen, die Corti im Paper zum Benchmark auswertet [4], und neben drei offenen Modellen, die wir auf denselben Aufnahmen gemessen haben. Zählweise und Einschränkungen erläutert der technische Bericht.
Schon ohne hinterlegtes Vokabular meistert ORPHEUS den anspruchsvollen MedTerm-Test mit synthetischen Stimmen
MedTerm stellt gezielt die schwierigen Stellen medizinischen Diktats auf die Probe, und ORPHEUS erkennt dabei allein mit seinem Standardwortschatz 96 von 100 Wörtern korrekt. Für den Alltag heißt das: Der Befund steht nach dem Diktat nahezu fertig im Dokument. Ärztinnen und Ärzte lesen gegen und passen einzelne Wörter an, statt Passagen neu zu schreiben. Die 200 Diktate sind synthetisch gesprochen, dauern zusammen 4,1 Stunden und enthalten seltene Fachbegriffe wie „Malgaigne-Beckenfraktur“, Datumsangaben, Dosierungen und Maße sowie gesprochene Befehle [1]. Gemessen wird die Wortfehlerrate, der Standardmaßstab für Spracherkennung, die falsche, fehlende und überzählige Wörter zählt und in Abbildung 1 dargestellt ist.
Unter Nutzung der Vokabular-Funktion von ORPHEUS verbessert sich das Ergebnis weiter, gerade bei seltenen Fachbegriffen
Mit der Vokabular-Funktion steigt die Erkennung über alle Wörter von 96 auf mehr als 98 von 100. In der täglichen Praxis können Nutzerinnen und Nutzer von ORPHEUS spezifische Begriffe zur Erkennung hinterlegen, etwa seltene Diagnosen, Medikamente, Eigennamen oder hausinterne Bezeichnungen. So passt sich ORPHEUS ohne neues Training an die Fachsprache einer Abteilung an. Um diese praktische Nutzung abzubilden, haben wir die seltenen Fachbegriffe hinterlegt, die MedTerm zu jedem Diktat eigens vorgibt und gesondert prüft, bis zu drei je Diktat. Schon diese wenigen Einträge haben die Zahl falsch erkannter Wörter mehr als halbiert.
Die Vokabular-Funktion erhöht zusätzlich die Trefferquote für seltene Fachbegriffe, eine Königsdisziplin im MedTerm-Benchmark, von 61 auf 98 Prozent. Dafür enthält MedTerm neben der Messung über alle Wörter einen eigenen Teiltest, der nur die vorgegebenen seltenen Fachbegriffe prüft, etwa „Malgaigne-Beckenfraktur“ oder „serielle transverse Enteroplastie“. Gezählt wird streng: Ein Begriff gilt nur dann als Treffer, wenn er vollständig und exakt richtig im Text steht; ist bei „serielle transverse Enteroplastie“ auch nur eines der drei Wörter falsch, zählt der ganze Begriff als verfehlt.
Auch mit echten Stimmen hält ORPHEUS sein hohes Niveau
Auf MedDictate, das mit echten statt synthetischen Stimmen arbeitet, erkennt ORPHEUS ohne Vokabular mehr als 93 von 100 Wörtern korrekt. Echte Stimmen bringen mehr Variation in Tempo, Aussprache und Sprechweise mit sich als synthetische. ORPHEUS ist für genau diese Bedingungen gebaut: Wir testen und entwickeln das System laufend im Realbetrieb weiter. MedDictate besteht aus neun echten Diktaten mit zusammen 33 Minuten Audio [2].
Für die deutschen MedDictate-Diktate gehört das zu den besten bislang veröffentlichten Ergebnissen. Wie sich die statistische Unschärfe bei neun Diktaten auf diese Einordnung auswirkt, erläutert der technische Bericht. Auch bei den Fachbegriffen, die MedDictate eigens prüft, erzielt ORPHEUS starke Ergebnisse: Schon ohne Vokabular kommen 84 Prozent exakt richtig heraus.
Neben der Sprache setzt ORPHEUS auch gesprochene Formatierungsbefehle zuverlässig um
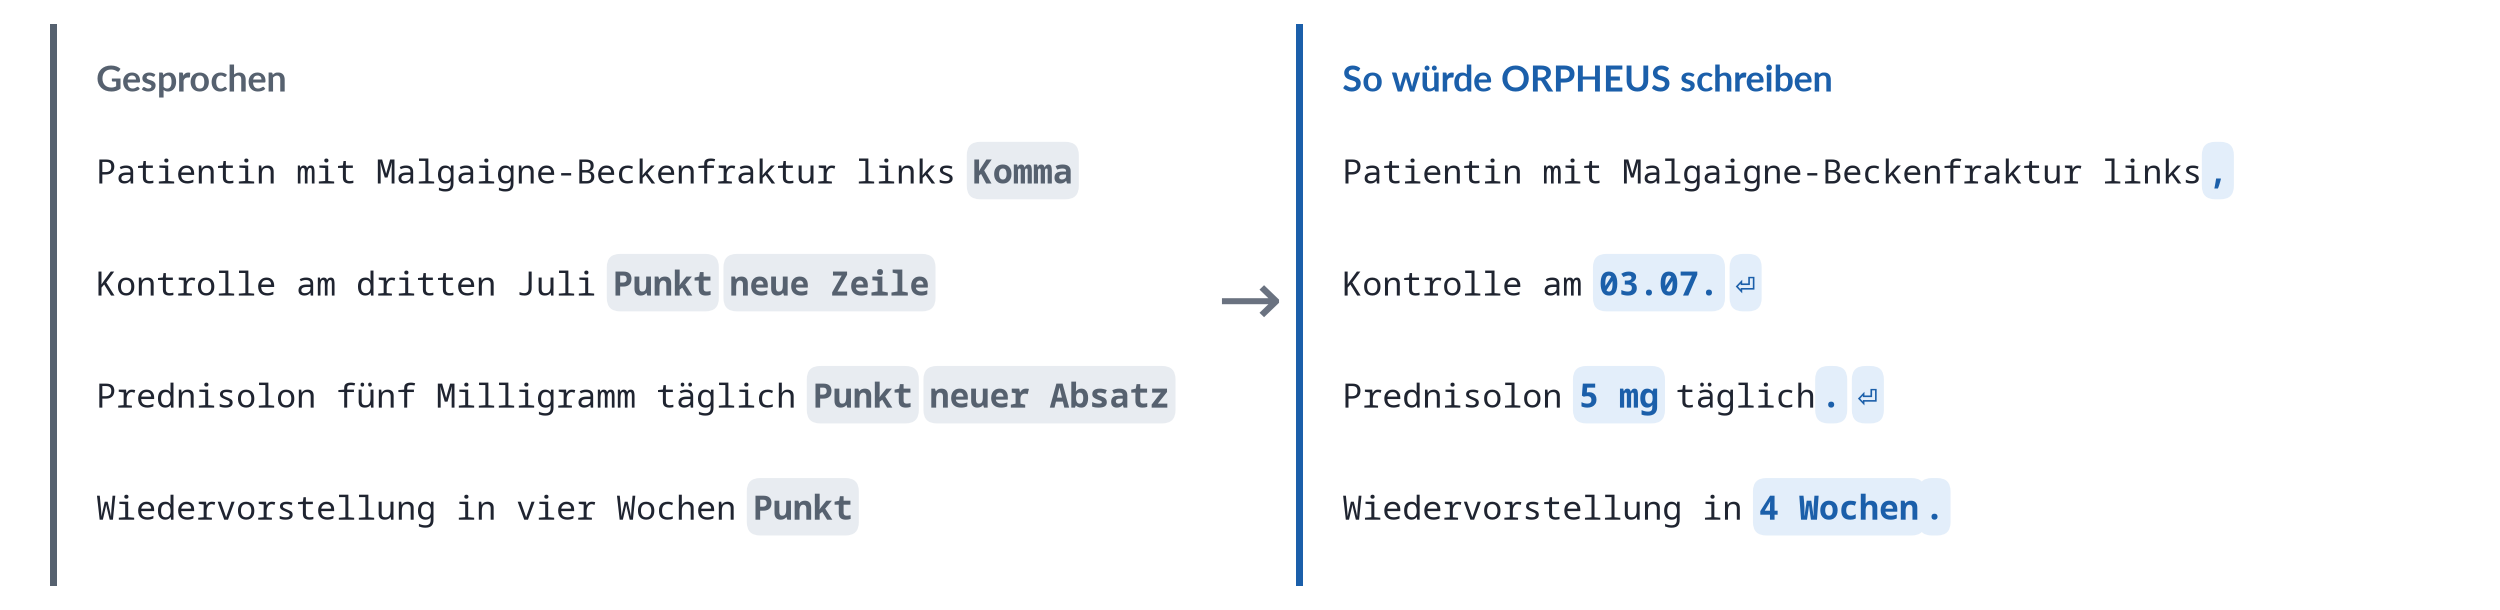
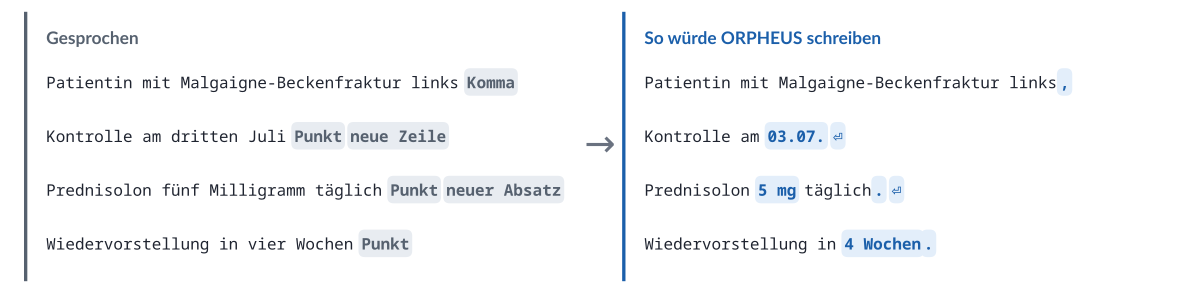
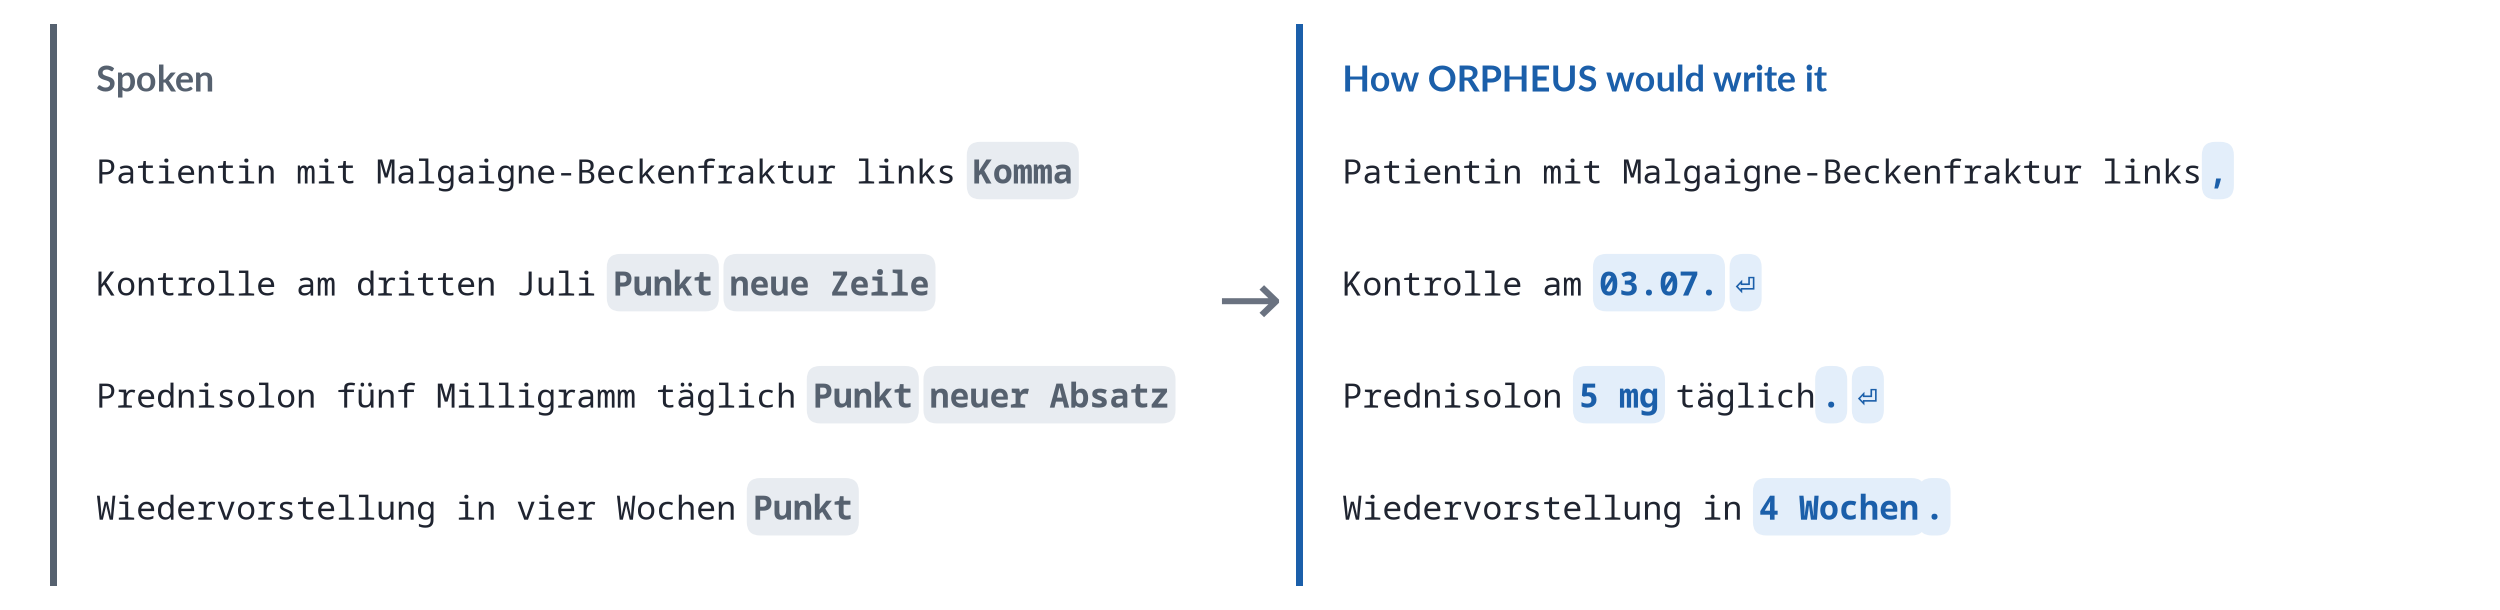
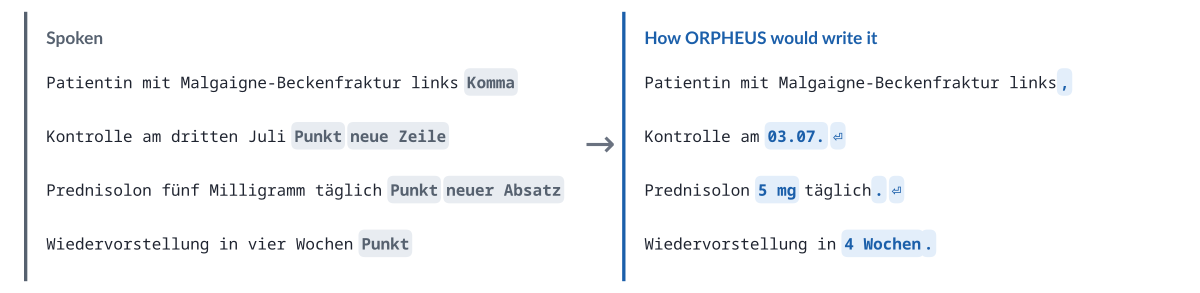
ORPHEUS setzt 95 Prozent der Befehle für Satzzeichen und Zeilenumbrüche korrekt um. Beide Benchmarks messen neben der Worterkennung eigens, ob solche gesprochenen Befehle umgesetzt werden. Sagt eine Ärztin „Punkt“, setzt ORPHEUS einen Punkt. Sagt sie „neue Zeile“, beginnt der nächste Text in einer neuen Zeile (Abbildung 2). Damit entsteht aus dem Diktat direkt ein strukturierter Text.
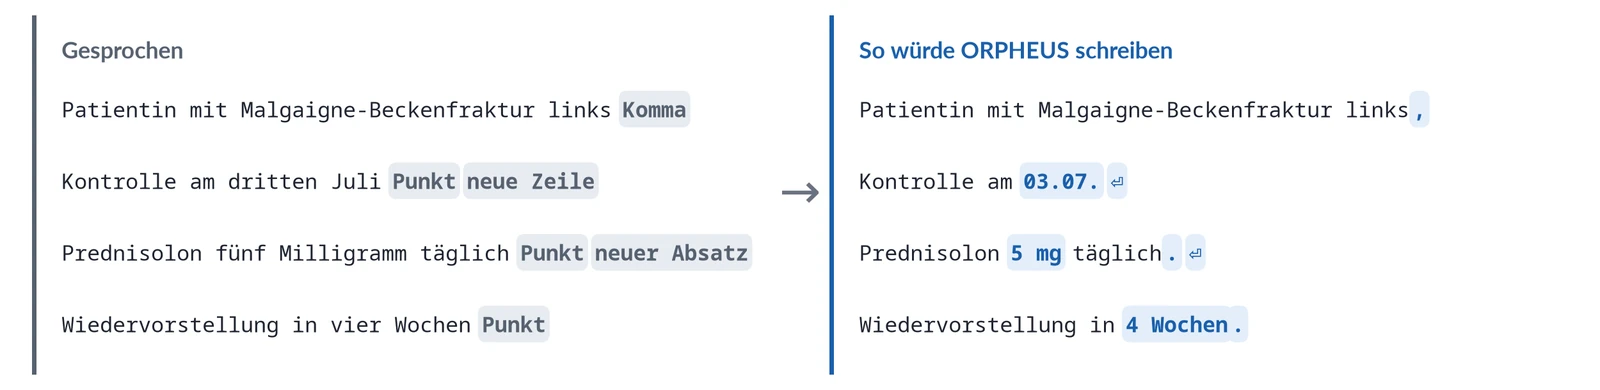
Abbildung 2: Eigenes Beispiel im Stil von MedTerm. Links das Gesprochene mit den Diktatbefehlen, rechts der Text, den ORPHEUS daraus schreibt (⏎ = Zeilenumbruch).
Seinen Mehrwert entfaltet dieses Ergebnis im Alltag, weil ORPHEUS den gegliederten Text direkt dort schreibt, wo der Befund entsteht. ORPHEUS schreibt an der Cursorposition in praktisch jede Klinik- und Praxissoftware; das Diktat landet so bereits gegliedert und ohne Umweg im Dokument. ORPHEUS läuft am Rechner und als App, kann in einer deutschen Cloud oder im Rechenzentrum der Einrichtung betrieben werden und ist heute in 40+ Kliniken und 500+ Praxen eingeführt.
Wir bleiben dran: für eine Spracherkennung, auf die sich Ärztinnen und Ärzte jeden Tag verlassen können
Unser Ziel ist eine Spracherkennung, die Ärztinnen und Ärzten Zeit für ihre Patientinnen und Patienten zurückgibt: messbar, souverän und zu Hause in der Sprache ihres Fachs. Öffentliche Benchmarks machen diesen Anspruch überprüfbar, und wir werden uns ihnen auch künftig stellen. Der nächste Maßstab ist der Stationsalltag mit Hintergrundgeräuschen, wechselnden Mikrofonen und Zeitdruck, den heutige Datensätze erst ansatzweise abbilden. Wir entwickeln ORPHEUS dafür weiter und veröffentlichen neue Ergebnisse, sobald sie vorliegen.
Danke an Corti für die Veröffentlichung von Daten und Verfahren.
Fragen, Kooperationsideen oder Kritik: hallo@idmedizin.de
Quellen
Technischer Bericht: Dr. J. Brederecke, L. Harmsen. „Wie gut versteht ORPHEUS medizinisches Diktat? Wir haben es getestet.“ September 2026.
[1] Corti. MedTerm, deutscher Teil (corti/med-term auf Hugging Face, Revision 47886572): 200 Aufnahmen synthetischer Sprache, 4,1 Stunden Audio. Lizenz CDLA-Permissive-2.0 mit Cortis Nutzungszusatz, der die Daten auf Evaluation beschränkt.
[2] Corti. MedDictate, deutscher Teil (corti/med-dictate auf Hugging Face, Revision 2a840558): 9 Aufnahmen echter Diktate, 33 Minuten Audio. Lizenz wie [1].
[3] Corti. bewer, Evaluation and analysis framework for automatic speech recognition in Python, Version 0.1.0a17, MIT-Lizenz. https://github.com/corticph/bewer
[4] A. Nix, R. James, L. Borgholt, A. B. Ekner, L. Krumm, J. Severin, D. Engel, L. Maaløe, J. Havtorn. „Symphony for Speech-to-Text: Supporting Real-Time Medical Voice Interfaces.“ arXiv:2605.16545v2 [cs.LG], Mai 2026. https://doi.org/10.48550/arXiv.2605.16545
Abbildungen herunterladen
Beide Abbildungen auf Deutsch und Englisch, als PNG (200 dpi) oder SVG (Vektor). Vor dem Speichern fragt der Browser nach.
| Abbildung 1: Wortfehlerrate MedTerm | Deutsch · PNG Deutsch · SVG Englisch · PNG Englisch · SVG |
|---|---|
| Abbildung 2: Diktatbeispiel | Deutsch · PNG Deutsch · SVG Englisch · PNG Englisch · SVG |
Über den Autor
Philipp Mühl
Product & Policy Strategy, IDM gGmbH
Verantwortet bei der IDM die Gemeinnützigkeit, die Außenkommunikation und den Austausch mit Politik und Gesellschaft.
LinkedIn →Verwandte Beiträge
Wie gut versteht ORPHEUS medizinisches Diktat? Wir haben es getestet
Wie wir ORPHEUS auf den öffentlichen Datensätzen MedTerm und MedDictate gemessen haben: Methode, Zählweisen, alle Kennzahlen mit Konfidenzintervallen, Vergleichswerte und Limitationen.
engineeringSo nutzen Sie ORPHEUS in Praxis und Klinik
Ein praktischer Überblick. Diktieren, das Gespräch ambient dokumentieren, mit Vorlagen strukturieren und Vokabular pflegen, Schritt für Schritt mit Screenshots aus dem ORPHEUS-Client.