Wie gut versteht ORPHEUS medizinisches Diktat? Wir haben es getestet
Jan Brederecke, Leo Harmsen
Kurz gesagt
Wir haben ORPHEUS auf zwei öffentlichen Datensätzen getestet und dabei festgestellt, dass es bei medizinischem Diktat weniger Fehler macht als Echtzeit-Varianten großer Allzweck-Systeme von ElevenLabs und OpenAI. Gleiches gilt auch für gängige offene Modelle wie OpenAI Whisper, Qwen3-ASR oder NVIDIA Parakeet. ORPHEUS liegt laut diesen Benchmarks nah an anderen auf Medizin spezialisierten Spracherkennungsmodellen, etwa Symphony von Corti und Scribe v2 Medical von ElevenLabs.
Hintergrund
ORPHEUS, unsere Software für medizinische Spracherkennung, ist heute in 40+ Kliniken und 500+ Praxen eingeführt. ORPHEUS entwickeln wir als gemeinnützige Tochter des Universitätsklinikums Hamburg-Eppendorf. Auch die KI-Modelle zur Spracherkennung trainieren und testen wir selbst und lokal.
Selbstverständlich können wir unsere Testdaten nicht veröffentlichen, weshalb ein nachvollziehbarer Vergleich mit anderen Spracherkennungssystemen bisher schwierig war.
Im Frühjahr hat die dänische Firma Corti ihr medizinisches Spracherkennungssystem Symphony [1] sowie zwei Datensätze (MedTerm [2], MedDictate [3]) veröffentlicht, auf denen wir ORPHEUS nun auch ausgiebig getestet haben (Stand: 28.09.2026). Beide Datensätze umfassen mehrere Sprachen; da ORPHEUS für deutsches Diktat entwickelt ist, werten wir jeweils nur den deutschen Teil aus.
Erster Datensatz: MedTerm
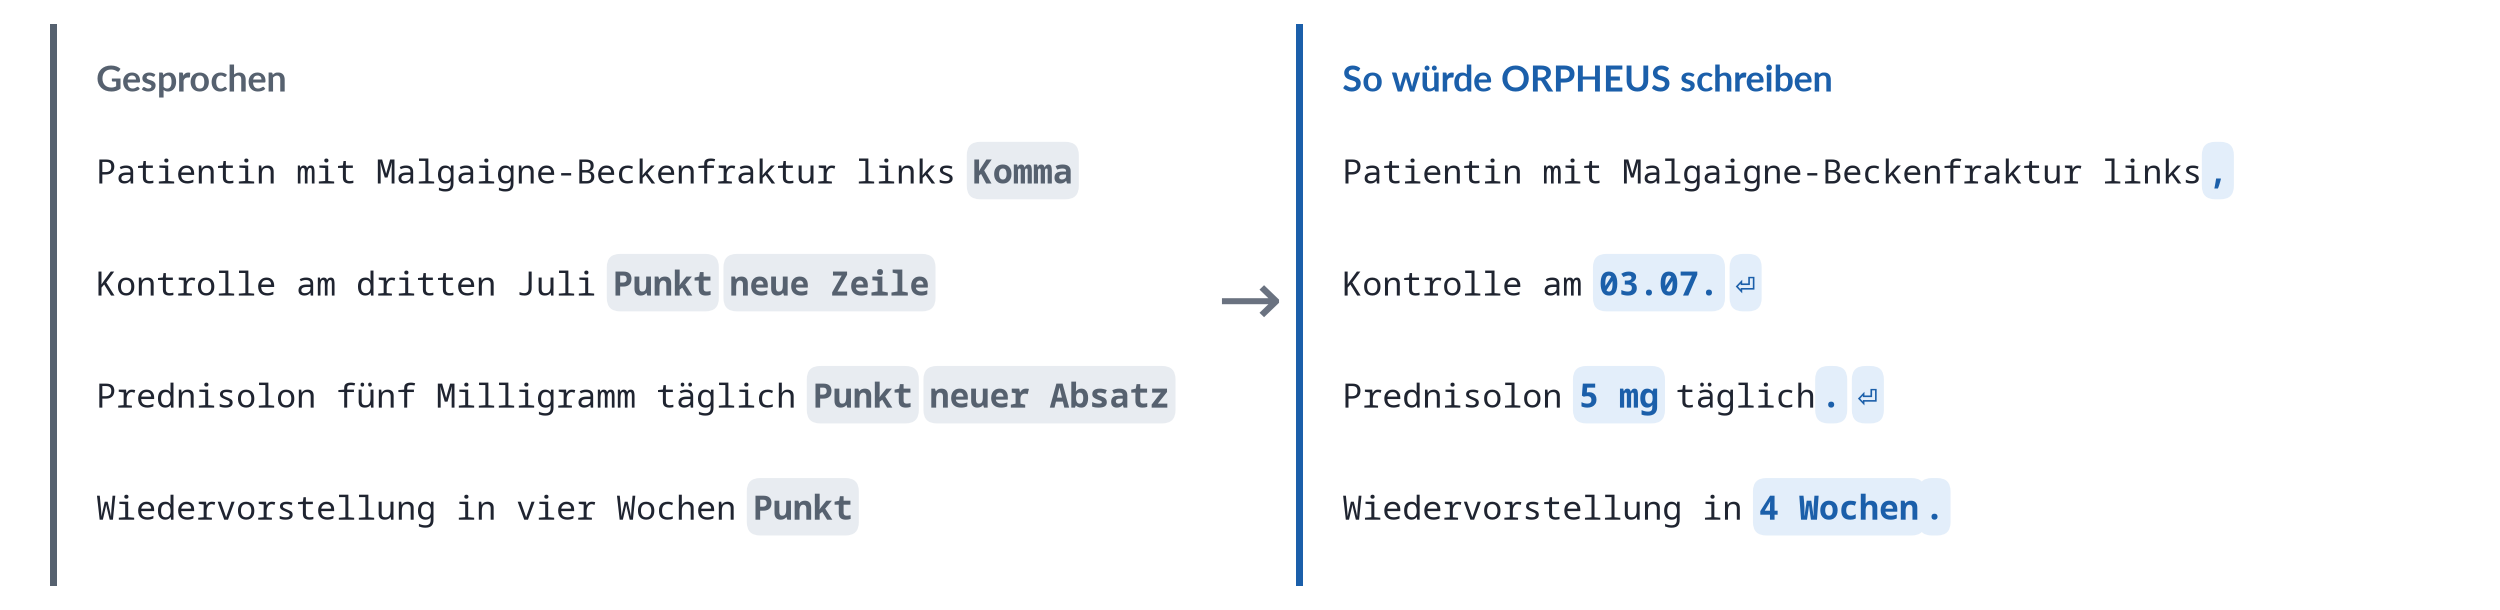
Die veröffentlichte Version von MedTerm enthält künstlich erzeugte deutsche Aufnahmen klinischer Notizen, die viel von dem abdecken, was medizinisches Diktat schwer macht: seltene Fachbegriffe ("Malgaigne-Beckenfraktur", "serielle transverse Enteroplastie"), Datumsangaben, Dosierungen, Maße, dazu gesprochene Formatierungsbefehle wie "Punkt", "Komma", "neue Zeile" oder "neuer Absatz". Zu jeder Aufnahme gibt es einen formatierten Referenztext und Listen der enthaltenen Fachbegriffe und Zahlenangaben. Abbildung 1 zeigt an einem Beispiel, wie so ein Diktat klingt und wie ORPHEUS es transkribieren würde.
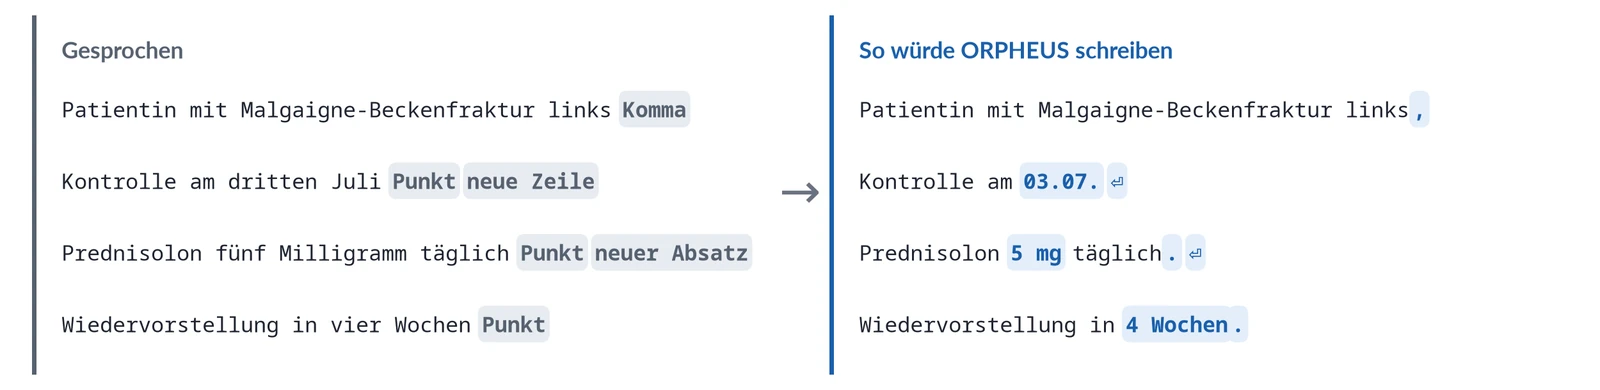
Abbildung 1: Eigenes Beispiel im Stil von MedTerm. Links das Gesprochene mit den Diktatbefehlen, rechts: so würde ORPHEUS es schreiben (⏎ = Zeilenumbruch).
Auch das Bewertungsverfahren ist öffentlich; es umfasst mehrere Metriken:
- Wortfehlerrate (WER): wie viele Fehler auf 100 Wörter der Referenz kommen, in diesem Fall ohne Groß-/Kleinschreibung und Satzzeichen zu werten.
- Trefferquote (Recall) und Präzision (Precision) bei Fachbegriffen: wie viele der gelisteten medizinischen Begriffe exakt richtig herauskommen und ob das System Fachbegriffe dort einsetzt, wo keine gesagt wurden.
- Formatierung: ob Datumsangaben und Zahlen exakt in der Schreibweise der Referenz erscheinen.
- Diktierte Zeichensetzung: ob gesprochene Satzzeichen und Zeilenumbrüche umgesetzt werden und keine Satzzeichen hinzugefügt werden, die niemand gesagt hat.
Corti berichtet diese Werte in Tabelle 4 des Papers [1] für Symphony und für vier Allzweck-Systeme (OpenAI, ElevenLabs, Whisper, Parakeet) auf den 499 deutschen Aufnahmen von MedTerm. Öffentlich verfügbar sind jedoch nur 200.
Methode
Alle von uns gemessenen Werte sind mit Cortis eigener, offen verfügbarer Auswertungsbibliothek bewer [4] berechnet. Um die Werte auf den öffentlichen Aufnahmen besser einordnen zu können, haben wir zusätzlich drei offene Allzweck-Modelle auf denselben 200 Aufnahmen durch die Auswertung geschickt: Voxtral Mini von Mistral [5], Whisper large-v3 von OpenAI [6] und Qwen3-ASR 1.7B von Alibaba [7]. Alle drei liefen in der Standardkonfiguration, ohne Finetuning, extra Prompting oder andere Eingriffe. Sie sind die einzigen Vergleiche auf exakt denselben Aufnahmen und dienen zugleich als grobe Plausibilitätsprüfung. Sie landeten alle in derselben Größenordnung, in der auch das Paper Systeme dieser Klasse einordnet. Unser Whisper-Wert liegt dabei mit 15,9 Prozent nah an den 15,6 Prozent, die das Paper für seine Whisper-Variante nennt. Das spricht dafür, dass sich die öffentlichen Aufnahmen ähnlich verhalten wie die 499 des Papers; belegen lässt es sich damit nicht.
ORPHEUS selbst haben wir in zwei Konfigurationen gemessen, die in der Klinik vorkommen, d. h. sowohl mit als auch ohne Nutzung der Vokabular-Funktion, in die man vor dem Diktat schwierige Begriffe eintragen kann. Für die Messung mit Vokabular haben wir dem System die Fachbegriffe mitgegeben, die der Datensatz selbst zu jeder Aufnahme bereithält (bis zu drei Begriffe pro Aufnahme). Das entspricht dann dem günstigsten Fall, dass jemand ORPHEUS so an den eigenen Sprachgebrauch angepasst hat, indem mit der Zeit bereits die Begriffe eingetragen wurden, die ggf. nicht zuverlässig erkannt wurden. Im Vokabular-Experiment des Corti-Papers, nur auf englischen Daten, bekam jede Aufnahme das gesamte Vokabular des Datensatzes [1, Tab. 7].
Konventionen
Die Referenzen schreiben Datumsangaben als "3. Juli 1995" und Ordnungszahlen bis neun als Wort ("der vierten Woche"). ORPHEUS schreibt "03.07.1995" und "der 4. Woche". Beides ist korrektes Deutsch, aber die Wortfehlerrate zählt solche Abweichungen als Fehler: Beim ausgeschriebenen Datum wären es gleich zwei oder drei. Deshalb nennen wir für unsere Messungen eine stilneutrale Wortfehlerrate, die nur echte Erkennungsfehler zählt: Referenz und Ausgabe werden vor dem Zählen symmetrisch auf eine Konvention gebracht. Ihre Regeln folgen den Kategorien der veröffentlichten Stilvorgabe [1, Abschn. 3.2]. Für die Systeme aus dem Paper lässt sich die stilneutrale Wortfehlerrate nicht berechnen, weil Corti deren ausgegebene Texte nicht veröffentlicht hat. Symphony trifft die Schreibweise der Referenzen bei Datums- und Zahlenangaben zu 99,5 Prozent [1, Tab. 4]; sein Wert ohne Angleichung dürfte daher nah am stilneutralen liegen. Bei den übrigen Systemen enthalten die Werte ohne Angleichung dagegen auch solche Scheinfehler und fallen deshalb vermutlich etwas schlechter aus. Bei allen Systemen, die wir selbst auf MedTerm gemessen haben, macht die Angleichung rund einen Punkt aus.
Die zweite Konvention ist eine Geste. Die Referenzen setzen "neuer Absatz" als Leerzeile und "neue Zeile" als Zeilenumbruch. ORPHEUS wurde darauf trainiert, beide Befehle als eine Geste mit einem Zeilenumbruch zu behandeln. Die stilneutralen Werte zählen deshalb einen Umbruch als Umbruch; Ergebnisse für beide Zählweisen stehen in Tabelle 1.
Ergebnisse auf MedTerm
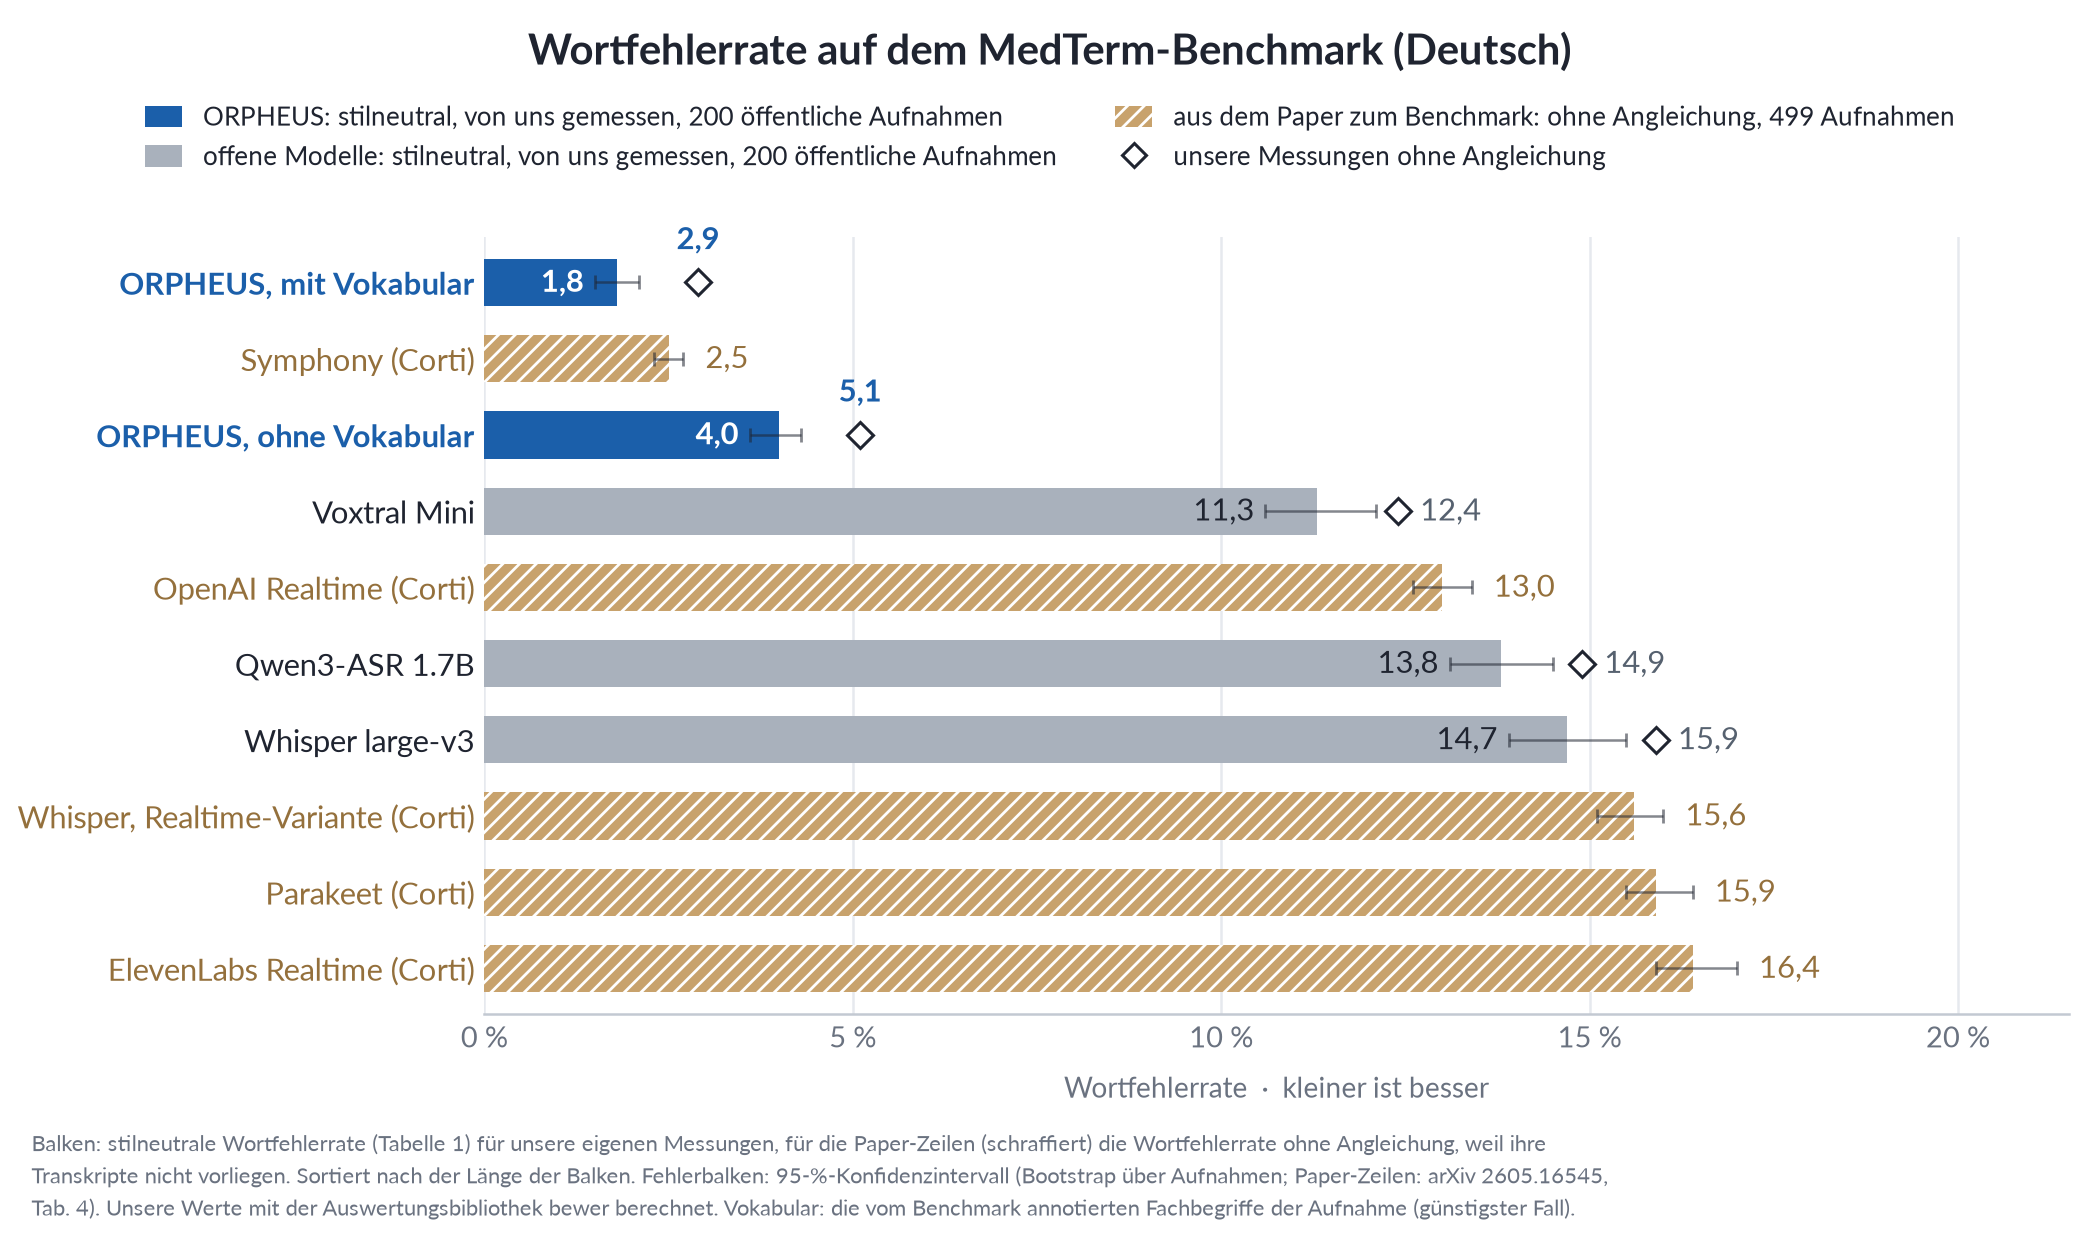
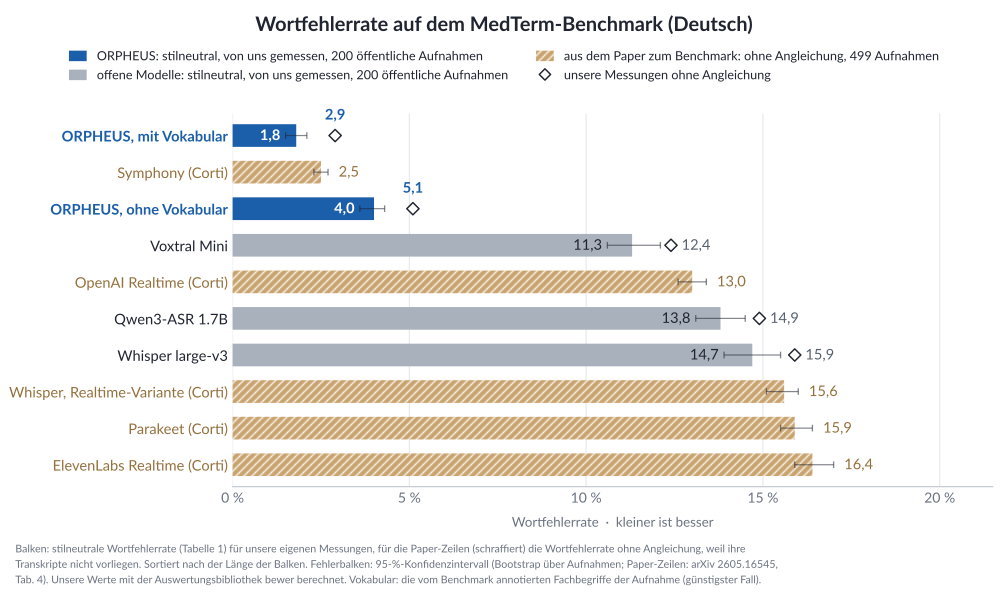
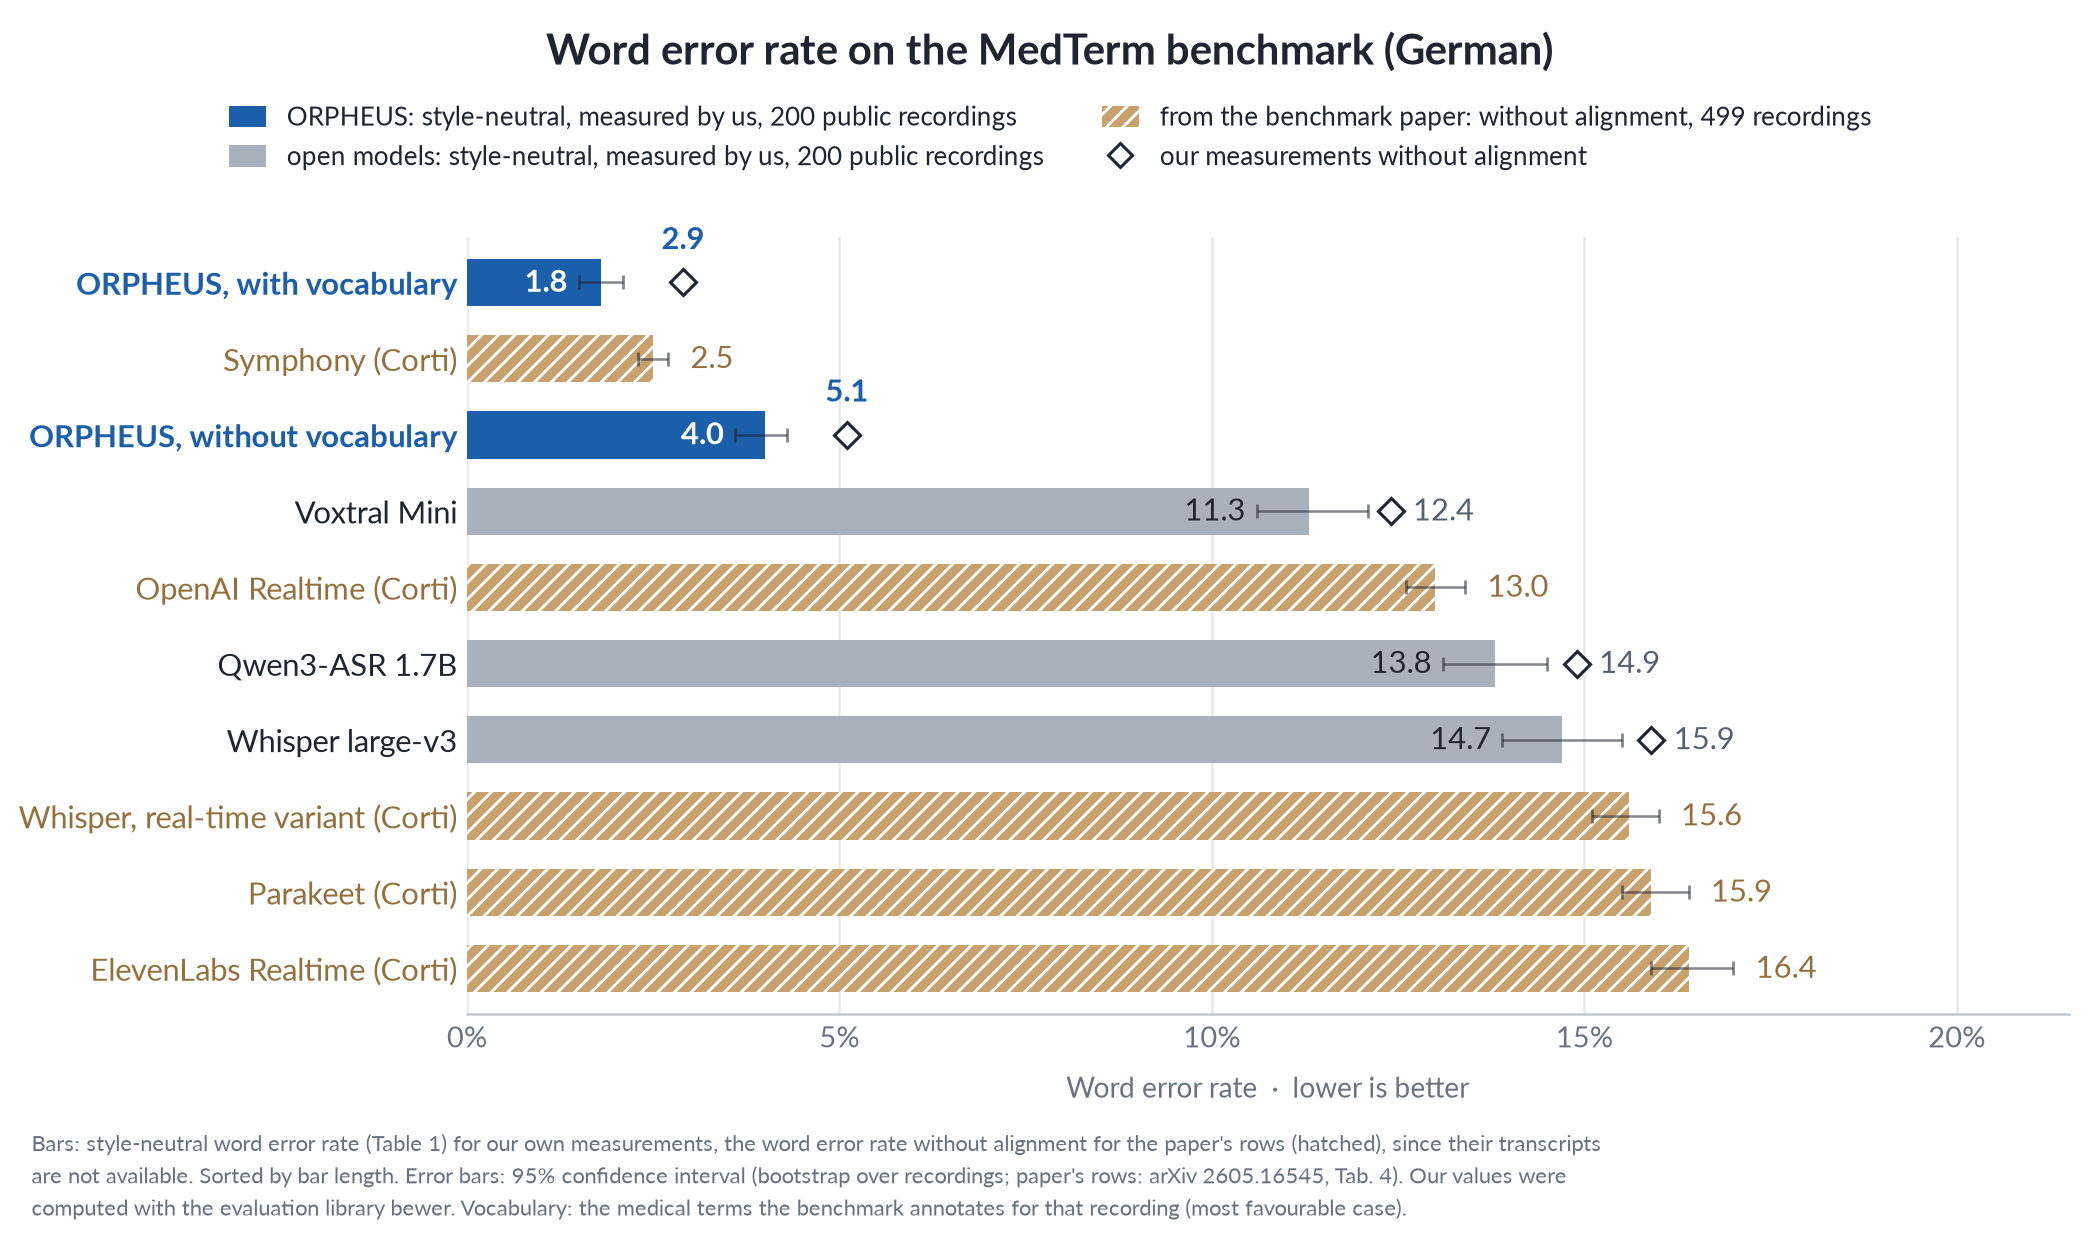
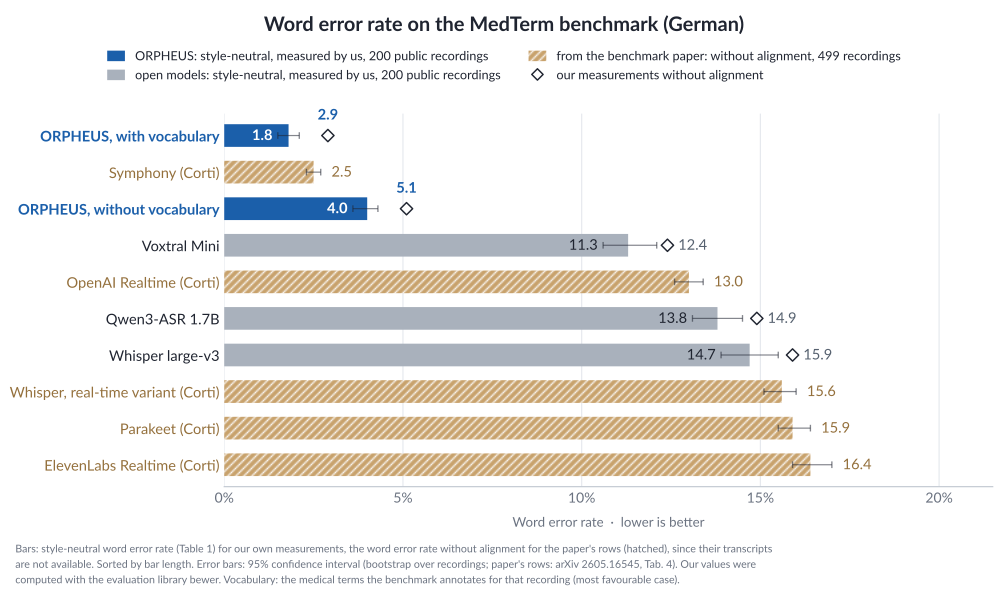
Stilneutral kommt ORPHEUS auf 4,0 Prozent Wortfehlerrate ohne und 1,8 Prozent mit Vokabular, Symphony laut Paper auf 2,5 Prozent. Die drei offenen Modelle machen auf denselben Aufnahmen stilneutral knapp drei- bis knapp viermal so viele Wortfehler wie ORPHEUS ohne Vokabular und sechs- bis gut achtmal so viele wie ORPHEUS mit Vokabular. Die Echtzeit-Varianten der kommerziellen Systeme von OpenAI und ElevenLabs kommen ohne Angleichung auf 13,0 und 16,4 Prozent. Eine strenge Rangfolge ist das nicht, weil die Aufnahmen nicht dieselben sind. Abbildung 2 stellt die Wortfehlerraten aller Systeme nebeneinander.
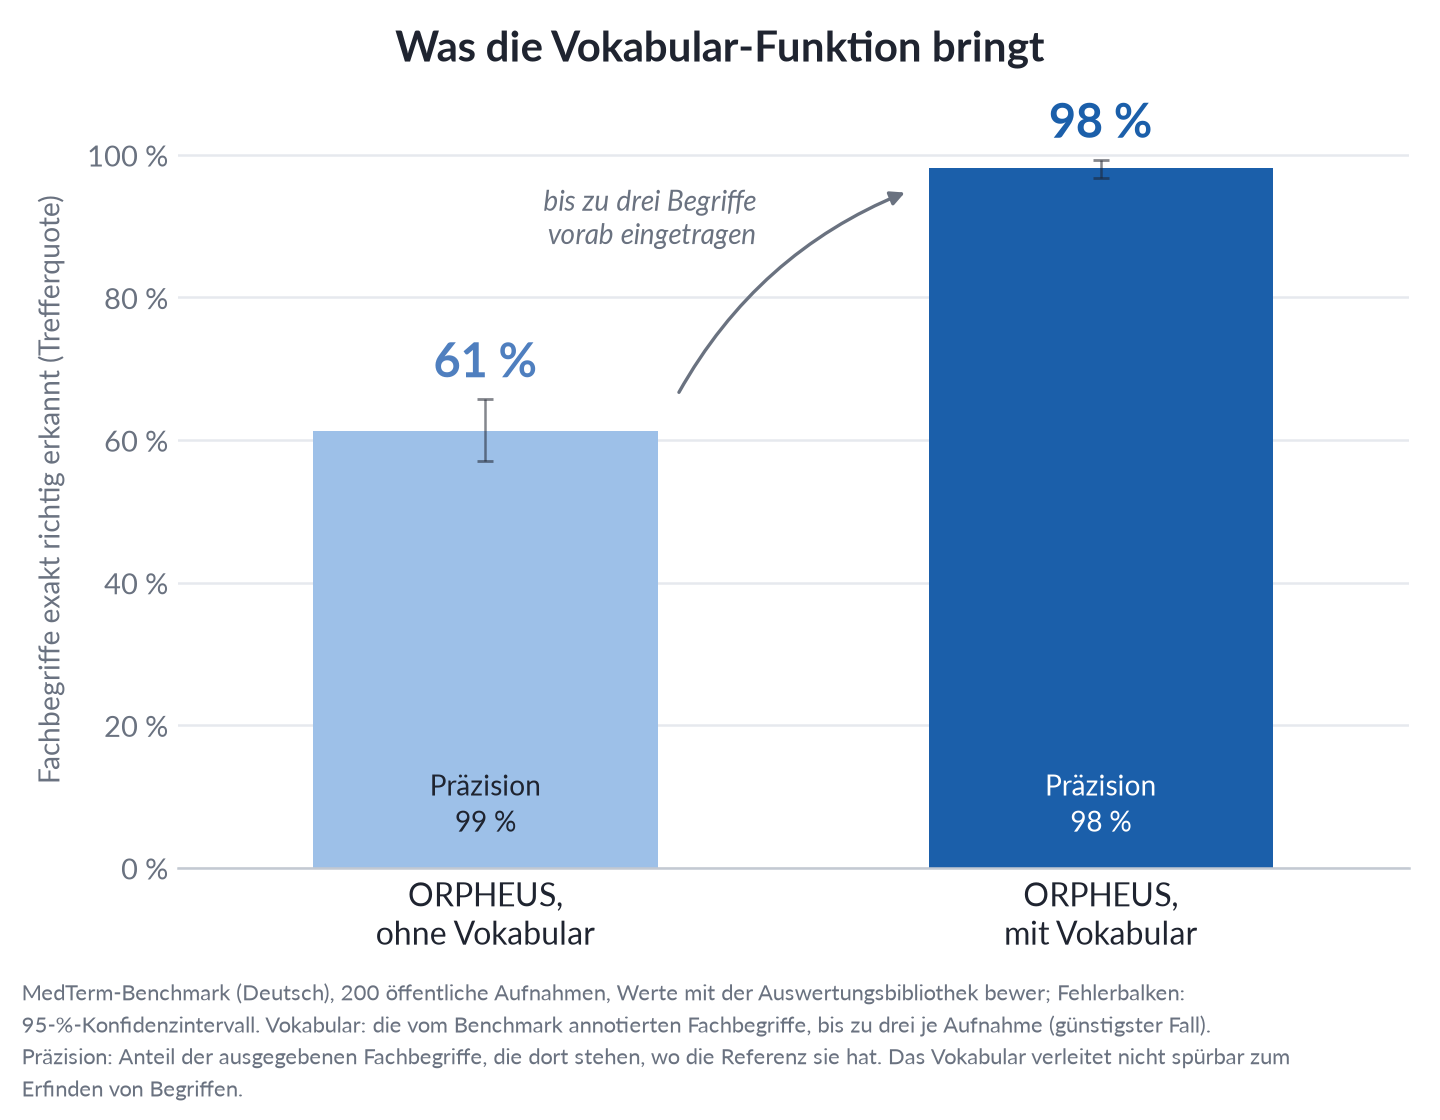
Ohne Vokabular findet ORPHEUS 61 Prozent der Fachbegriffe, die Allzweck-Systeme 48 bis 71 und Symphony 76 Prozent. Mit Vokabular gibt ORPHEUS 98 Prozent der Fachbegriffe exakt richtig aus, und die Präzision sinkt dabei nur von 99 auf 98 Prozent. Weil das Vokabular hier nur Begriffe enthielt, die in der Aufnahme auch vorkommen, zeigt das allerdings nicht, wie sich ein großes Vokabular mit vielen nicht gesagten Begriffen verhält. Wie viel Symphonys eigenes Vokabular auf den deutschen Daten bringt, ist nicht veröffentlicht. Abbildung 3 stellt die Trefferquote ohne und mit Vokabular gegenüber.
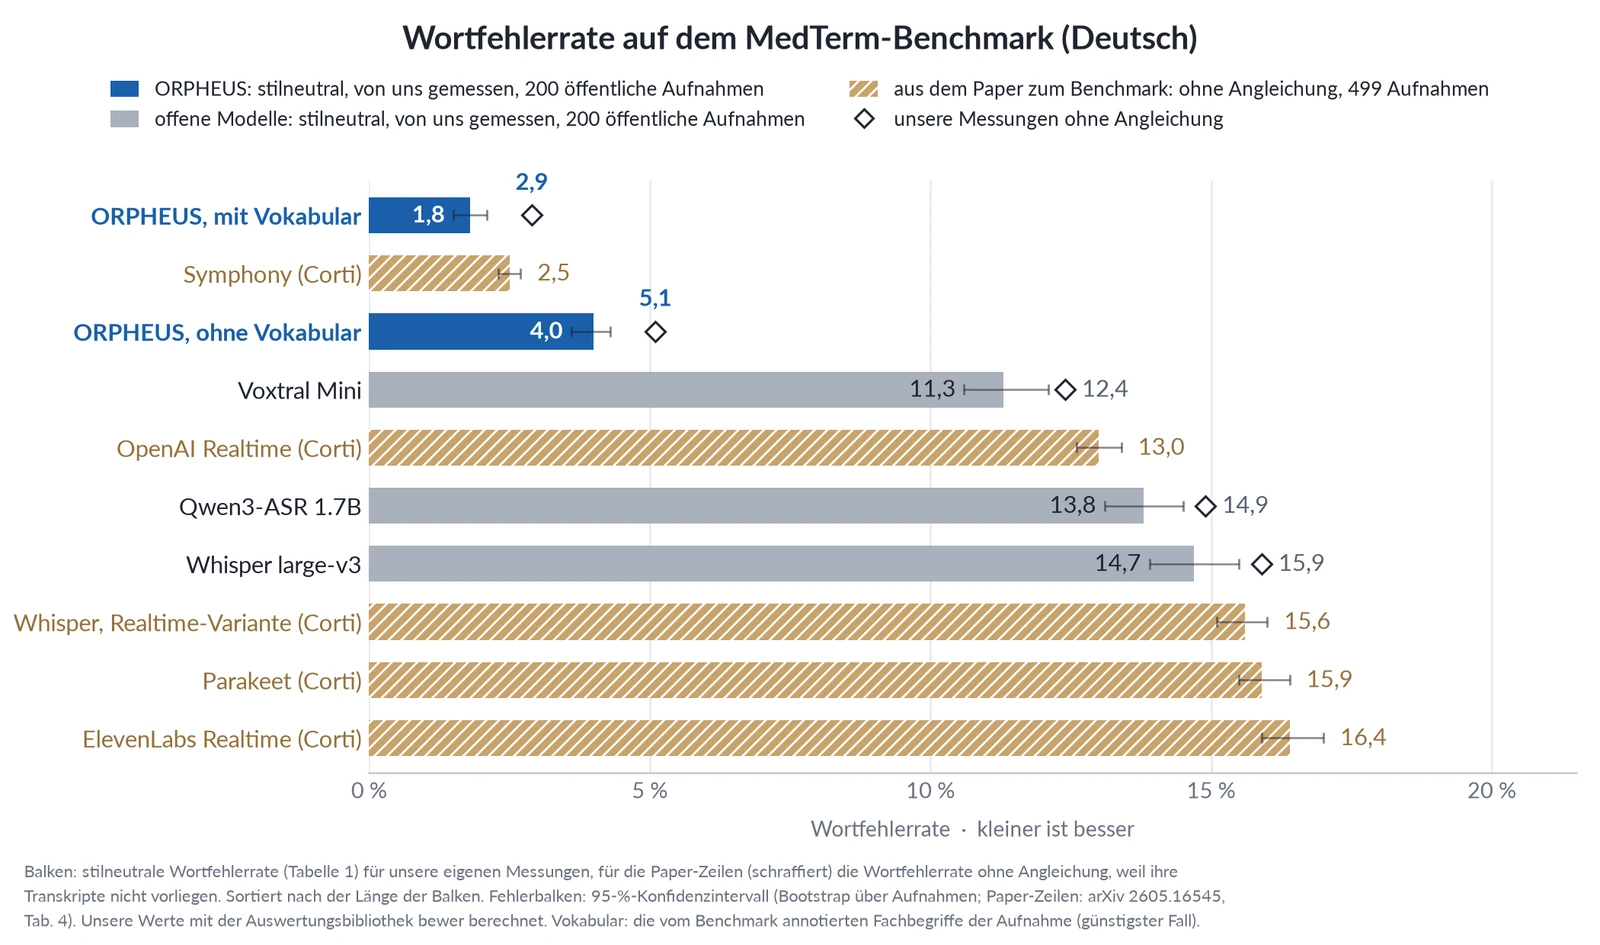
Abbildung 2: Wortfehlerrate auf MedTerm, deutscher Teil. Für unsere eigenen Messungen zeigen die Balken den stilneutralen Wert, die Rauten den Wert ohne Angleichung. Für die Systeme aus dem Paper gibt es nur den Wert ohne Angleichung (schraffiert), weil ihre Transkripte nicht vorliegen.
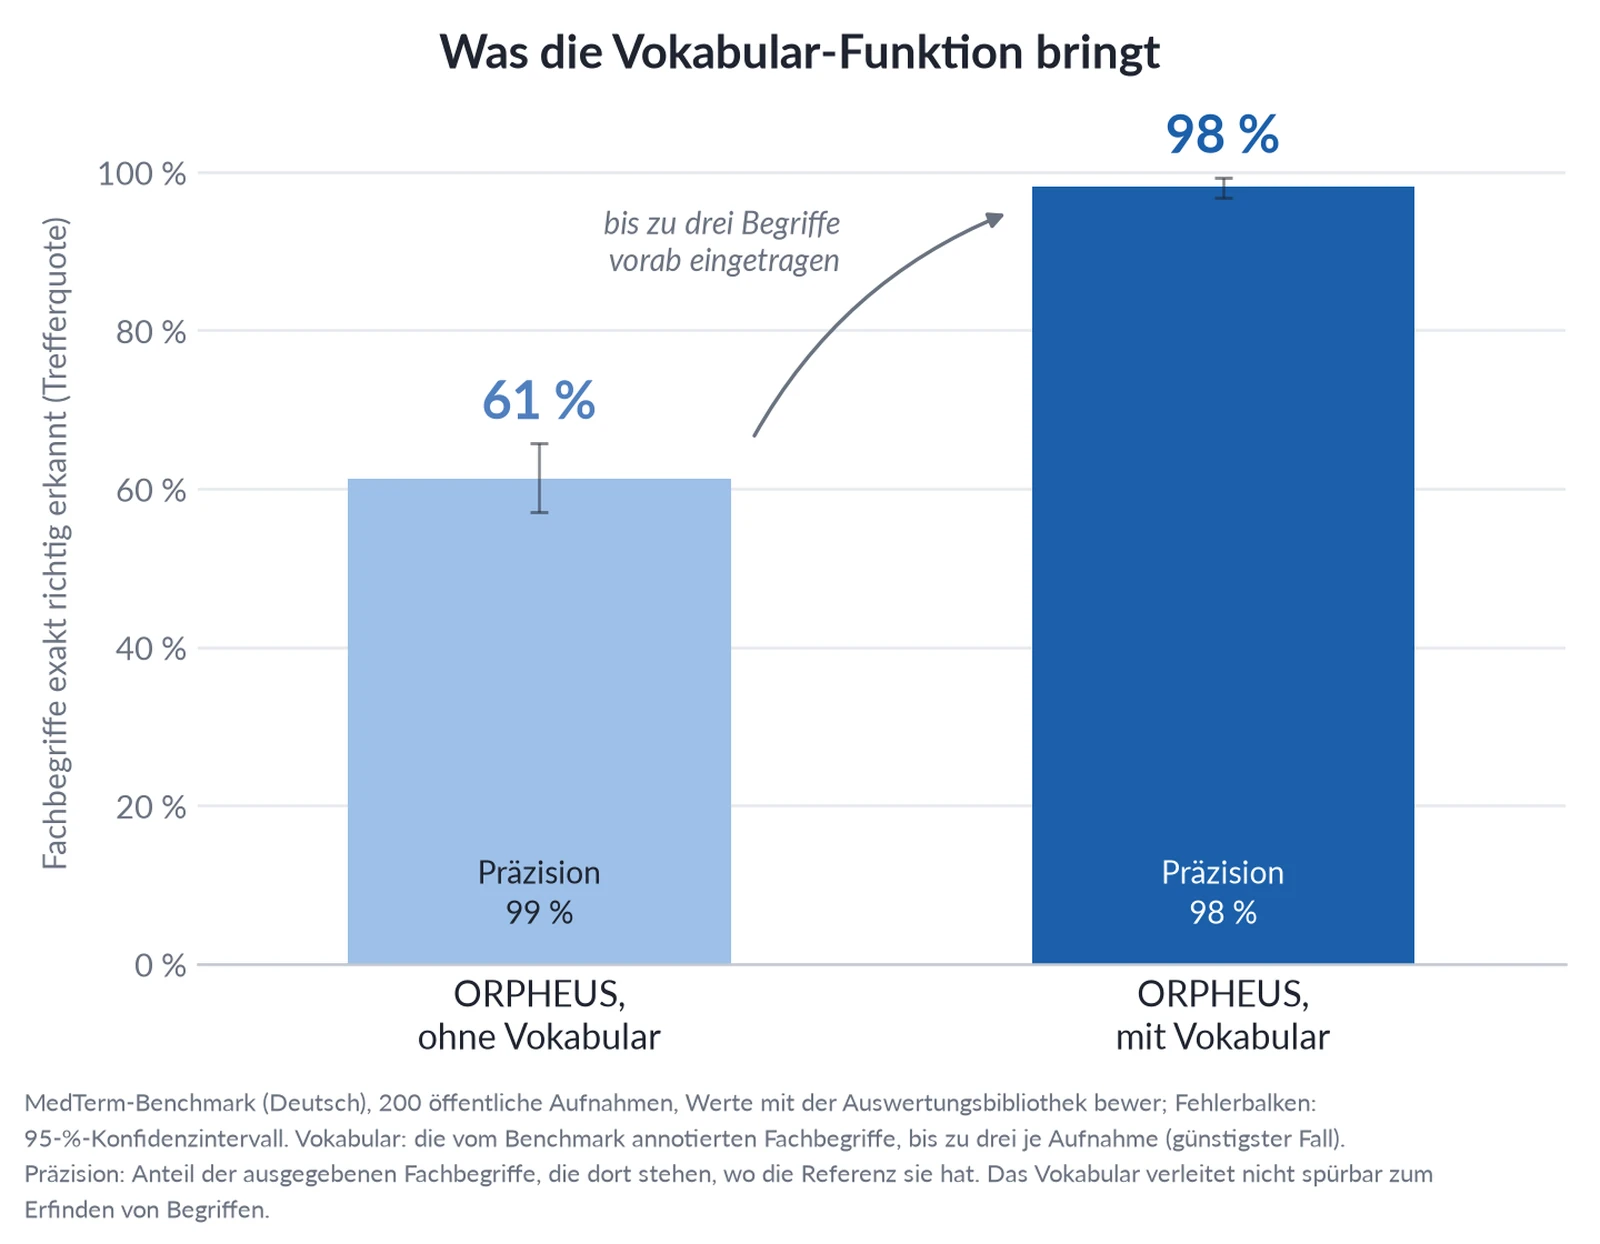
Abbildung 3: Trefferquote von ORPHEUS bei Fachbegriffen auf MedTerm, ohne und mit Vokabular.
Bei der diktierten Zeichensetzung setzt ORPHEUS ohne Vokabular stilneutral, also mit dem Absatz-Unterschied herausgerechnet, 95 Prozent der gesprochenen Satzzeichen und Umbrüche um; Symphony kommt auf 94. Allerdings setzt ORPHEUS häufiger auch Satzzeichen, die niemand diktiert hat (Präzision 85 gegenüber 91 Prozent). Die Allzweck-Systeme treffen höchstens rund die Hälfte, vermutlich weil sie Satzzeichen nach eigenem Ermessen setzen, statt auf die gesprochenen Befehle zu hören.
Tabelle 1: MedTerm, deutscher Teil. Werte in Prozent, außer Aufn.
| System | Aufn. | Wortfehlerrate | Fachbegriffe | Formatierung | Zeichensetzung | ||||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| WER | WER° | Treffer | Präzision | Treffer | Treffer° | Treffer | Treffer° | Präzision | Präzision° | ||
| ORPHEUS, mit den annotierten Fachbegriffen als Vokabular | 200 | 2,9 [2,5; 3,3] | 1,8 [1,5; 2,1] | 98,1 [96,7; 99,3] | 97,8 | 60,5 | 91,2 | 84,8 | 98,4 | 83,2 | 89,1 |
| ORPHEUS, ohne Vokabular | 200 | 5,1 [4,6; 5,5] | 4,0 [3,6; 4,3] | 61,3 [57,0; 65,7] | 99,4 | 60,0 | 90,5 | 81,8 | 95,3 | 79,1 | 84,8 |
| Voxtral Mini | 200 | 12,4 [11,5; 13,2] | 11,3 [10,6; 12,1] | 52,9 [48,9; 57,5] | 99,8 | 57,5 | 84,5 | 41,1 | 52,2 | 25,6 | 29,3 |
| Qwen3-ASR 1.7B | 200 | 14,9 [14,2; 15,7] | 13,8 [13,1; 14,5] | 48,3 [44,3; 52,7] | 99,2 | 50,0 | 74,2 | 38,9 | 51,3 | 23,9 | 27,7 |
| Whisper large-v3 | 200 | 15,9 [15,1; 16,8] | 14,7 [13,9; 15,5] | 52,4 [47,9; 56,9] | 99,8 | 44,4 | 74,2 | 36,9 | 49,0 | 22,6 | 26,7 |
| Symphony (Corti) | 499 | 2,5 [2,3; 2,7] | n. b. | 75,6 [73,4; 77,9] | k. A. | 99,5 | n. b. | 94,1 | n. b. | 90,8 | n. b. |
| OpenAI Realtime (Corti) | 499 | 13,0 [12,6; 13,4] | n. b. | 70,6 [68,0; 73,0] | k. A. | 84,8 | n. b. | 40,3 | n. b. | 25,6 | n. b. |
| ElevenLabs Realtime (Corti) | 499 | 16,4 [15,9; 17,0] | n. b. | 62,9 [60,3; 65,5] | k. A. | 84,5 | n. b. | 38,8 | n. b. | 19,2 | n. b. |
| Whisper, Realtime-Variante (Corti) | 499 | 15,6 [15,1; 16,0] | n. b. | 57,1 [54,8; 59,7] | k. A. | 81,9 | n. b. | 33,9 | n. b. | 20,1 | n. b. |
| Parakeet (Corti) | 499 | 15,9 [15,5; 16,4] | n. b. | 51,1 [48,6; 53,7] | k. A. | 81,3 | n. b. | 32,4 | n. b. | 20,0 | n. b. |
Zweiter Datensatz: MedDictate, echte Stimmen
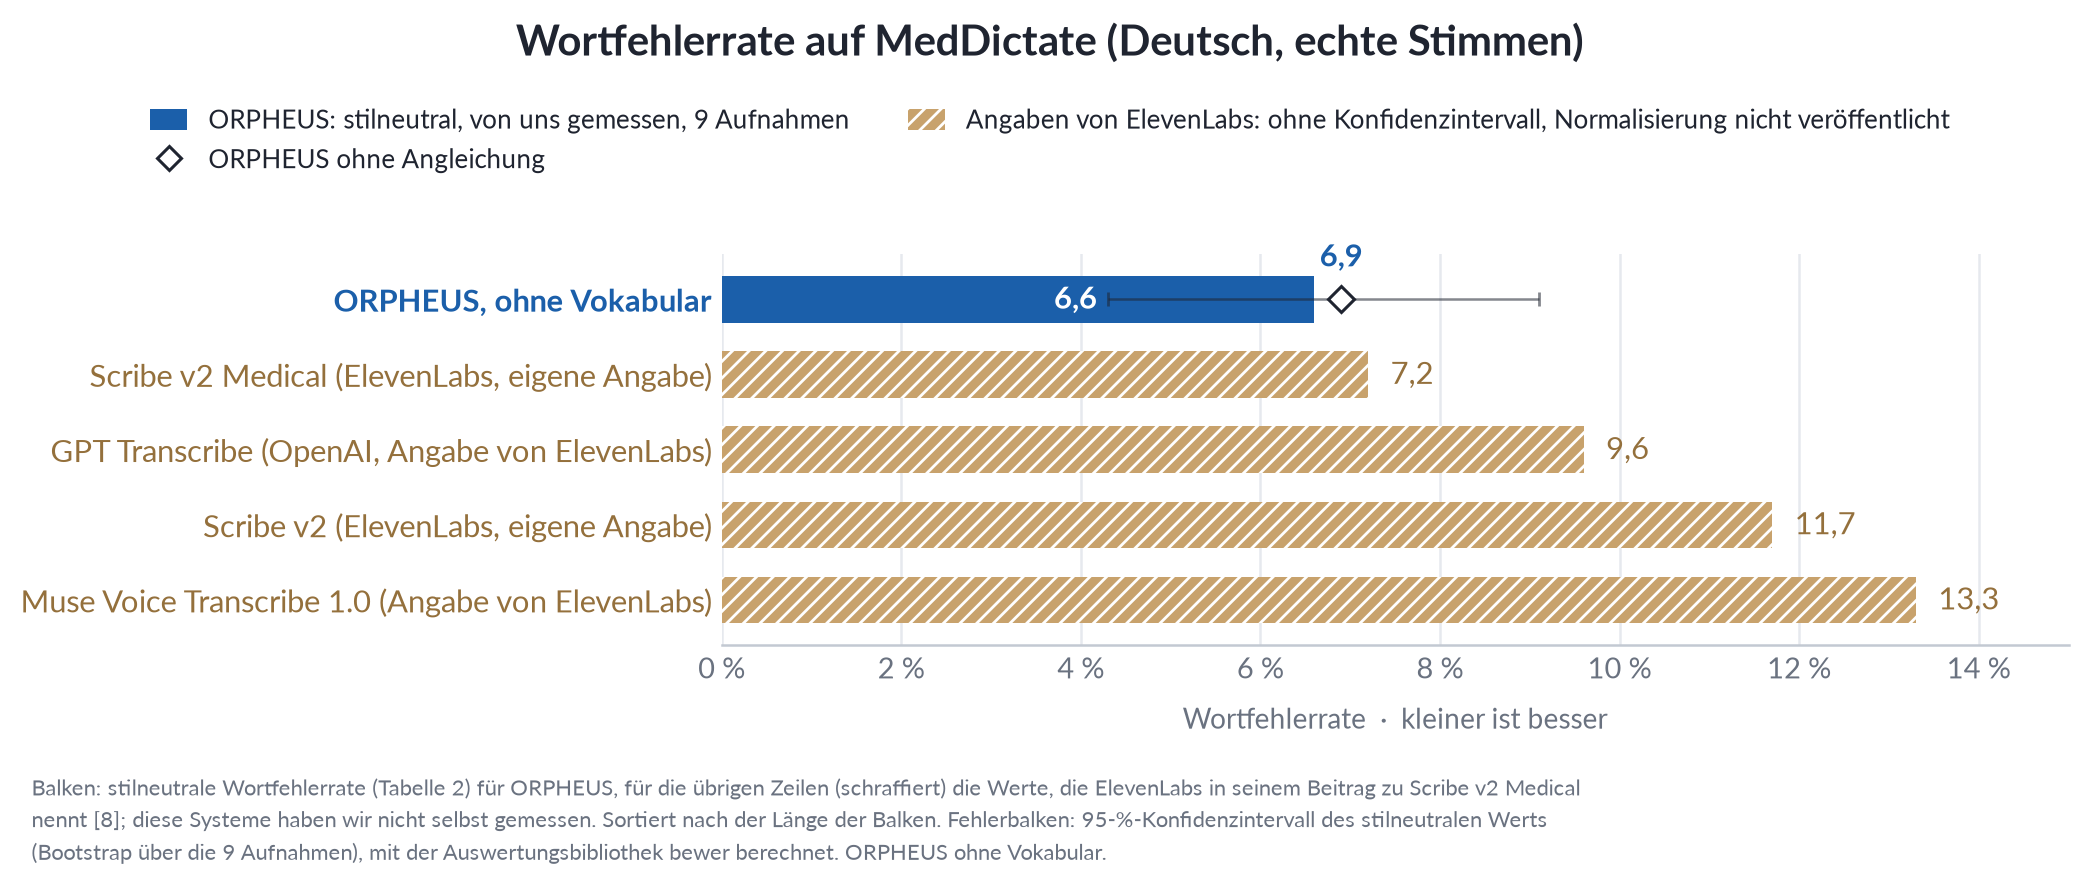
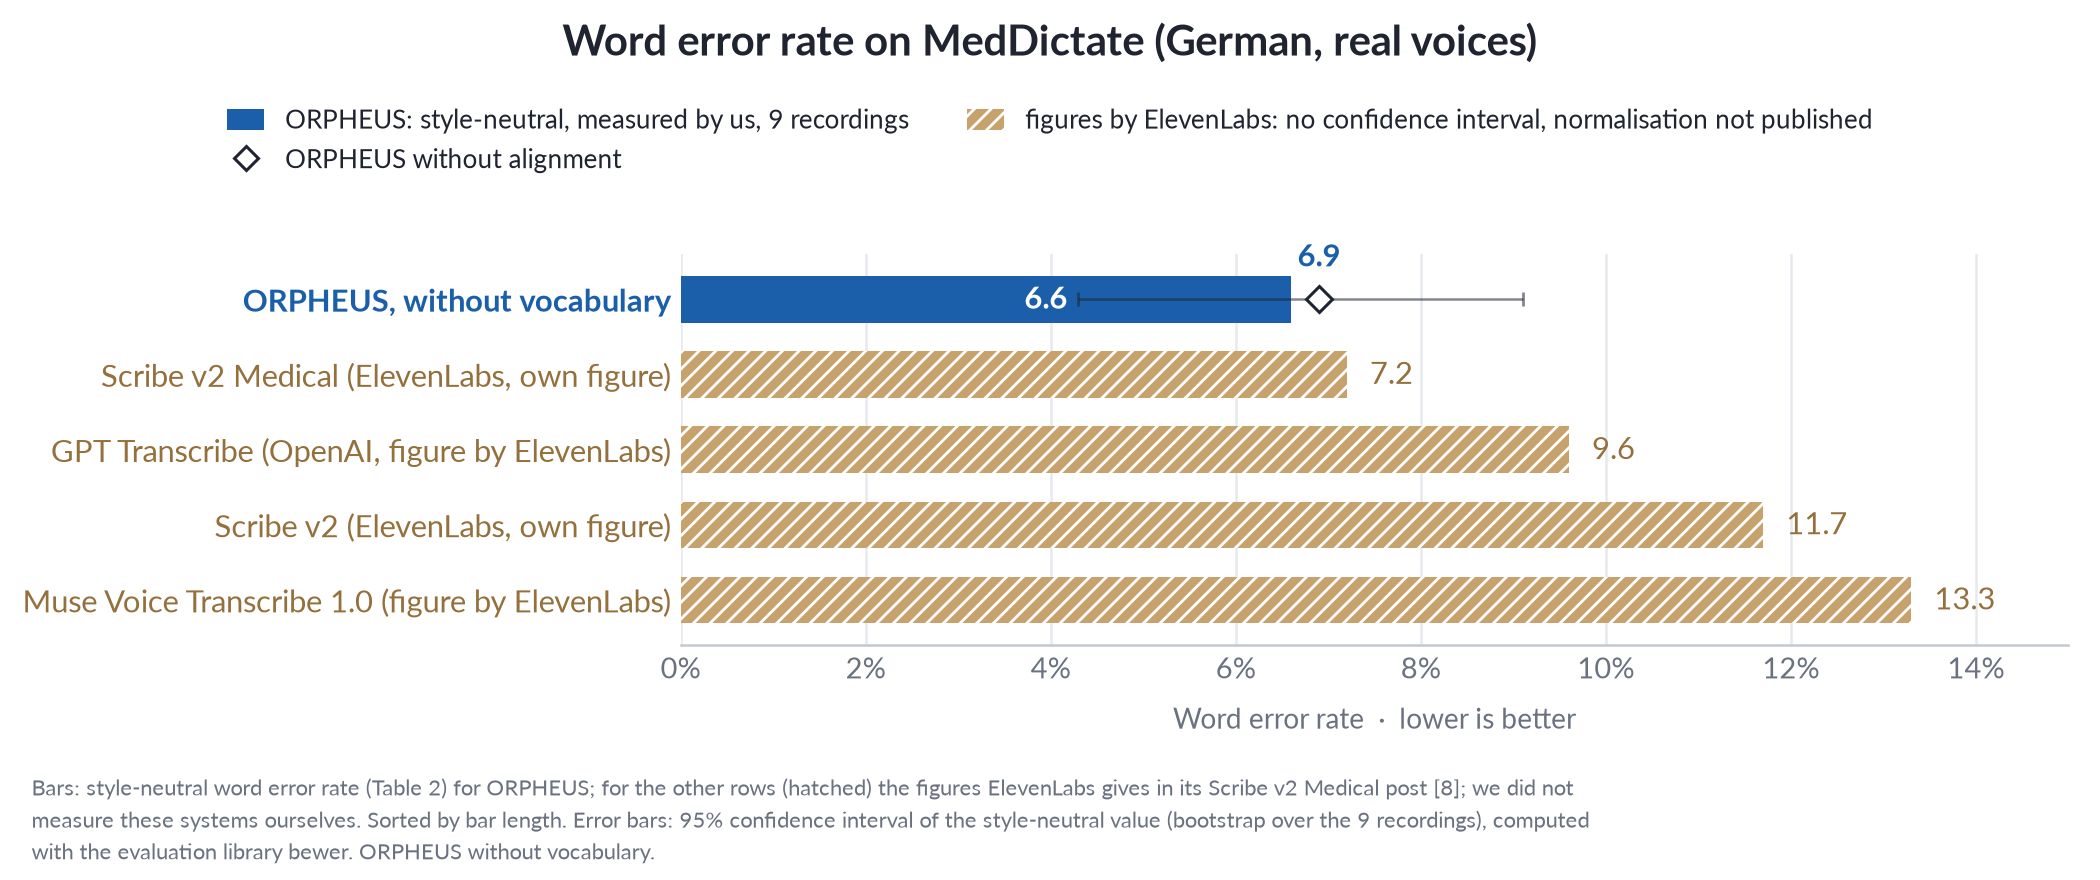
Kurz vor der Veröffentlichung dieses Beitrags hat ElevenLabs das neue Scribe v2 Medical vorgestellt, eine auf klinisches Audio angepasste Variante seiner Spracherkennung [8]. ElevenLabs berichtet dafür Werte auf dem zweiten öffentlichen Datensatz, MedDictate [3]: auf den deutschen Aufnahmen eine Wortfehlerrate von 7,2 Prozent, für OpenAIs GPT Transcribe 9,6, für das allgemeine Scribe v2 11,7 und für Muse Voice Transcribe 1.0 13,3 Prozent. Die MedTerm-Werte im selben Beitrag fassen Englisch, Französisch und Deutsch zusammen; mit Tabelle 1 sind sie daher nicht vergleichbar.
Der deutsche Teil von MedDictate besteht aus neun echten Diktaten, zusammen 33 Minuten lang. Eingesprochen haben sie u. a. Mitarbeiter von Corti. Jedes ist zwischen knapp zwei und siebeneinhalb Minuten lang und enthält 35 bis 139 Fachbegriffe. Aufbau und Auswertung entsprechen MedTerm. Damit entfällt der wichtigste Vorbehalt gegen MedTerm, die synthetischen Stimmen. Dafür ist der Datensatz klein, und entsprechend breit fallen die von uns berechneten Konfidenzintervalle aus. Für Symphony gibt es auf den deutschen MedDictate-Daten keine veröffentlichten Werte.
Wir haben ORPHEUS hier für bestmögliche Vergleichbarkeit ohne Vokabular gemessen. ORPHEUS kommt dabei stilneutral auf eine Wortfehlerrate von 6,6 Prozent, mit einem Konfidenzintervall von 4,3 bis 9,1. Die 7,2 Prozent, die ElevenLabs für Scribe v2 Medical angibt, liegen in diesem Intervall; beide Systeme liegen also in derselben Größenordnung. Die Werte, die ElevenLabs für GPT Transcribe, das allgemeine Scribe v2 und Muse Voice Transcribe 1.0 nennt, liegen oberhalb unseres Intervalls. Es gilt allerdings auch hier eine wichtige Einschränkung: ElevenLabs hat nicht veröffentlicht, wie die Texte vor dem Zählen normalisiert wurden, und wir haben diese Systeme nicht selbst gemessen. Ob beide Zahlen auf exakt demselben Verfahren beruhen, wissen wir deshalb nicht. Abbildung 4 stellt die Werte nebeneinander.
Von den annotierten Fachbegriffen kommen hier 84 Prozent exakt richtig heraus, die Präzision liegt bei über 99 Prozent. Die diktierte Zeichensetzung trifft ORPHEUS stilneutral zu 95 Prozent.
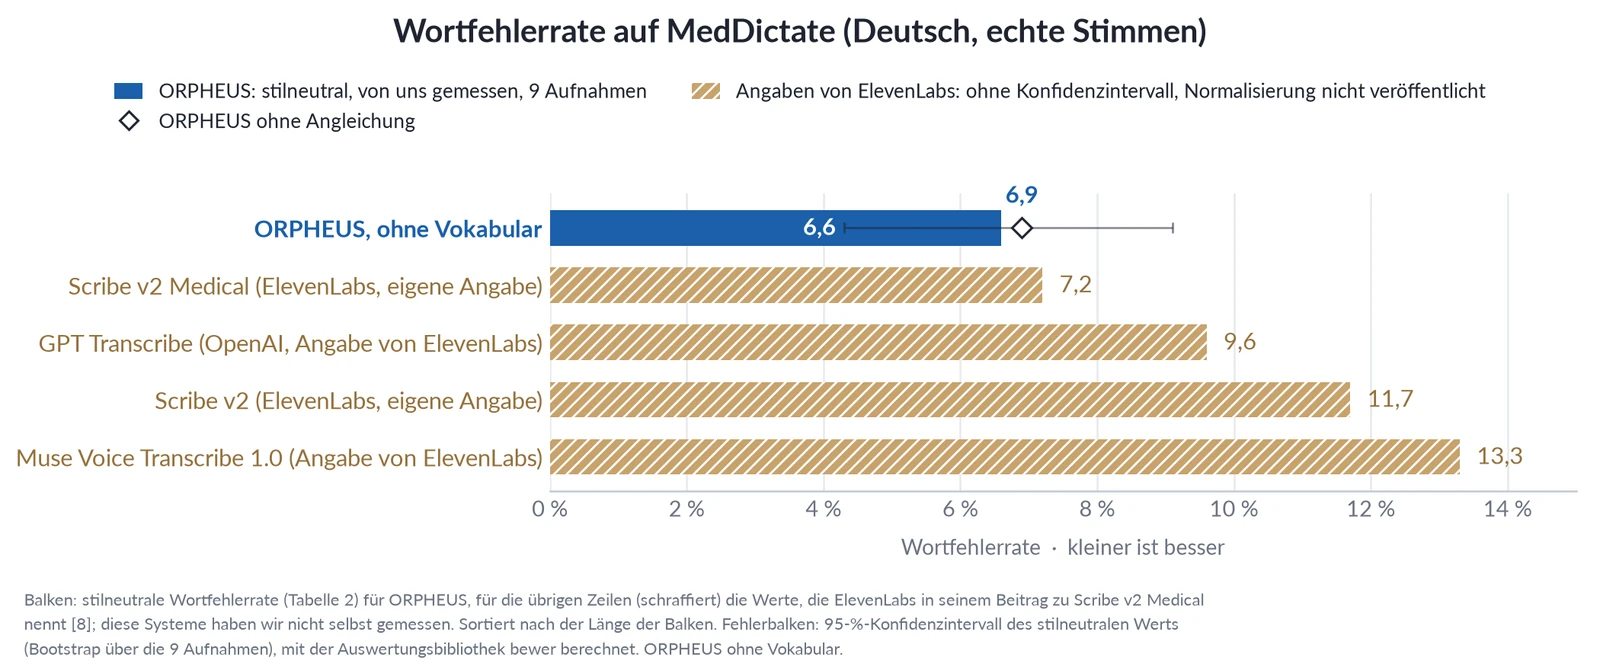
Abbildung 4: Wortfehlerrate auf MedDictate, deutscher Teil. Für ORPHEUS zeigt der Balken den stilneutralen Wert, die Raute den Wert ohne Angleichung. Die übrigen Werte stammen von ElevenLabs (schraffiert); wie dort normalisiert wurde, ist nicht veröffentlicht.
Tabelle 2: MedDictate, deutscher Teil. Werte in Prozent, außer Aufn.; unsere Zeile berechnet mit bewer [4], die übrigen aus der Veröffentlichung von ElevenLabs [8].
| System | Aufn. | WER | WER° | Fachbegriffe, Treffer | Präzision | Formatierung, Treffer | Treffer° | Zeichensetzung, Treffer | Treffer° | Präzision |
|---|---|---|---|---|---|---|---|---|---|---|
| ORPHEUS, ohne Vokabular | 9 | 6,9 [4,4; 9,4] | 6,6 [4,3; 9,1] | 83,8 [78,0; 88,8] | 99,6 | 86,7 | 88,0 | 89,3 | 95,0 | 97,0 |
| Scribe v2 Medical (ElevenLabs, eigene Angabe) | 9 | 7,2 | n. b. | k. A. | k. A. | k. A. | n. b. | k. A. | n. b. | k. A. |
| GPT Transcribe (OpenAI, Angabe von ElevenLabs) | 9 | 9,6 | n. b. | k. A. | k. A. | k. A. | n. b. | k. A. | n. b. | k. A. |
| Scribe v2 (ElevenLabs, eigene Angabe) | 9 | 11,7 | n. b. | k. A. | k. A. | k. A. | n. b. | k. A. | n. b. | k. A. |
| Muse Voice Transcribe 1.0 (Angabe von ElevenLabs) | 9 | 13,3 | n. b. | k. A. | k. A. | k. A. | n. b. | k. A. | n. b. | k. A. |
Lesehilfe zu Tabelle 1 und 2
- Aufn.: Zahl der ausgewerteten Aufnahmen. Die mit "(Corti)" markierten Zeilen stammen aus dem Paper [1, Tab. 4].
- WER: Wortfehlerrate, also Ersetzungen, Auslassungen und Einfügungen je 100 Referenzwörter, ohne Groß-/Kleinschreibung und Satzzeichen. Kleiner ist besser.
- Fachbegriffe, Treffer und Präzision: Anteil der annotierten Fachbegriffe, die exakt richtig herauskommen. Ein Begriff zählt nur, wenn jedes seiner Wörter stimmt. Die Präzision zeigt, ob ein System Fachbegriffe setzt, wo keine gesagt wurden; wichtig vor allem bei der Vokabular-Zeile.
- Formatierung: Anteil der annotierten Datums- und Zahlenangaben, exakt wie geschrieben. Die Spalte ist nur eingeschränkt vergleichbar: Whisper large-v3 erreicht auf den 200 öffentlichen Aufnahmen stilneutral 74 Prozent, das Paper nennt für seine Whisper-Variante 82.
- Zeichensetzung, Treffer und Präzision: Anteil der diktierten Satzzeichen und Umbrüche, die umgesetzt werden. Die Referenzen enthalten nur, was gesprochen wurde; selbst hinzugefügte Satzzeichen gehen zulasten der Präzision.
- °: derselbe Wert nach dem Angleichen beider Texte auf eine Konvention (Ordnungszahlen, Zahlwörter, numerische Daten, Uhrzeiten, Maße, Bereiche und Absatz-zu-Zeilenumbruch), symmetrisch, sodass die Angleichung keinen falschen Wert reparieren kann.
- n. b.: ohne Transkripte nicht berechenbar; k. A.: nicht veröffentlicht.
- [a; b]: 95-%-Konfidenzintervall aus 1.000 Bootstrap-Stichproben über die Aufnahmen. Für unsere Messungen haben wir es selbst berechnet, für die Zeilen aus dem Paper ist es aus [1, Tab. 4] übernommen. Aus Platzgründen steht es nur bei der Wortfehlerrate und der Fachbegriff-Trefferquote; für die übrigen Spalten nennt die Tabelle den Punktwert.
- Vokabular: die vom Benchmark zur jeweiligen Aufnahme annotierten Fachbegriffe (bis zu drei), dem System mitgegeben.
Einordnung
Erstens: ORPHEUS macht auf MedTerm deutlich weniger Wortfehler als die Echtzeit-Varianten der kommerziellen Systeme von OpenAI und ElevenLabs sowie frei verfügbare Modelle. Bei der Wortfehlerrate liegt es nah an Cortis Symphony, diktierte Satzzeichen und Umbrüche setzt es zuverlässig um.
Zweitens: Die Messung auf echten Stimmen deutet darauf hin, dass das Ergebnis hält, auch wenn der Datensatz mit neun Aufnahmen klein ist. Auf MedDictate kommt ORPHEUS stilneutral auf 6,6 Prozent Wortfehlerrate und liegt damit in derselben Größenordnung wie das neue Scribe v2 Medical.
Drittens: Ohne Vokabular erkennt ORPHEUS seltene Fachbegriffe zwar weniger zuverlässig als Symphony, die Nutzung der Vokabular-Funktion schließt diese Lücke jedoch: Sie senkt die Fehlerrate und erhöht die Trefferquote bei Fachbegriffen deutlich, ohne dass die Präzision nennenswert sinkt. Im Alltag fällt der Effekt realistischerweise kleiner aus, weil niemand alle schwierigen Begriffe vorher kennt. Die Funktion erlaubt aber eine gezielte Anpassung an den eigenen Sprachgebrauch ohne erneutes Training.
Viertens: Außer ORPHEUS sind alle Systeme, so wie sie hier verglichen werden, Programmierschnittstellen (APIs) oder frei verfügbare Modelle. Eine API oder eine Modelldatei allein ist für eine Praxis oder Klinik noch kein Diktiersystem: Dazu fehlen eine Anwendung am Arbeitsplatz, die Anbindung an Mikrofon und Klinik- oder Praxissoftware, Benutzerverwaltung und Support, bei einem Modell außerdem eigene GPU-Server und deren Betrieb. ORPHEUS ist dagegen eine fertige Software: Es schreibt direkt an der Cursorposition in praktisch jede Klinik- und Praxissoftware, läuft am Rechner und als App und wird in einer deutschen Cloud oder im Rechenzentrum des Hauses betrieben.
Limitationen
Der Vergleich mit Symphony und den übrigen Systemen, die wir nicht selbst gemessen haben, ist eine Annäherung: Aufnahmen, Messmodus und zum Teil die Normalisierung unterscheiden sich. Direkt vergleichbar sind nur unsere eigenen Messungen auf denselben Aufnahmen. Unsere Werte für MedTerm stammen nur von den 200 öffentlichen Aufnahmen. Ob sie unter den 499 des Papers sind und wie sie ausgewählt wurden, ist nicht dokumentiert. Wir haben ORPHEUS nicht im Streamingmodus gemessen; alle mit "(Corti)" markierten Zeilen in Tabelle 1, auch Symphony, stammen dagegen aus Echtzeit-Messungen (Streaming) [1, Tab. 4]. Stilneutrale Werte konnten wir nur für unsere eigenen Messungen berechnen; dass Symphonys Wert ohne Angleichung nah am stilneutralen liegt, ist eine Annahme. Die drei offenen Vergleichsmodelle liefen in Standardkonfiguration und dürften mit gezieltem Finetuning noch einmal besser abschneiden. Etablierte Diktiersysteme anderer Anbieter, wie sie in vielen Kliniken und Praxen im Einsatz sind, fehlen im Vergleich: Werte auf diesen Datensätzen sind uns für sie nicht bekannt, und außer ORPHEUS haben wir nur frei verfügbare Modelle selbst gemessen. Die MedTerm-Aufnahmen sind saubere synthetische Sprache, eine Art von Daten, die im Training von ORPHEUS bisher nicht vorkommt; MedDictate besteht aus echten Stimmen, ist aber sehr klein, und die Vergleichswerte dort stammen von ElevenLabs selbst. Über laute Krankenhausstationen, weiter entfernte Mikrofone oder zögerliche Sprecher sagen beide Datensätze nur wenig aus.
Ausblick
Wir arbeiten laufend an ORPHEUS und werden auch künftig neue Ergebnisse hier zeigen. Die Benchmarks zeigen uns dabei deutlich, wo wir als Nächstes ansetzen: bei der Erkennung seltener Fachbegriffe ohne Vokabular und bei der Zeichensetzung, vor allem darin, keine Satzzeichen zu setzen, die niemand diktiert hat. Unser Ziel bleibt hochwertige, souveräne und transparente medizinische Software und KI für Kliniken und Praxen.
Danke an Corti für die Veröffentlichung von Daten und Verfahren.
Fragen, Kooperationsideen, Kritik: hallo@idmedizin.de
Quellen
[1] A. Nix, R. James, L. Borgholt, A. B. Ekner, L. Krumm, J. Severin, D. Engel, L. Maaløe, J. Havtorn. "Symphony for Speech-to-Text: Supporting Real-Time Medical Voice Interfaces." arXiv:2605.16545v2 [cs.LG], Mai 2026. https://doi.org/10.48550/arXiv.2605.16545
[2] Corti. MedTerm, deutscher Teil (corti/med-term auf Hugging Face, Revision 47886572): 200 Aufnahmen synthetischer Sprache, 4,1 Stunden Audio. Lizenz CDLA-Permissive-2.0 mit Cortis Nutzungszusatz, der die Daten auf Evaluation beschränkt.
[3] Corti. MedDictate, deutscher Teil (corti/med-dictate auf Hugging Face, Revision 2a840558): 9 Aufnahmen echter Diktate, 33 Minuten Audio. Lizenz wie [2].
[4] Corti. bewer, Evaluation and analysis framework for automatic speech recognition in Python, Version 0.1.0a17, MIT-Lizenz. https://github.com/corticph/bewer
[5] A. H. Liu, A. Ehrenberg, A. Lo, C. Denoix, C. Barreau u. a. (Mistral AI). "Voxtral." arXiv:2507.13264v1 [cs.SD], Juli 2025. Gemessenes Modell: mistralai/Voxtral-Mini-3B-2507, Lizenz Apache-2.0.
[6] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, I. Sutskever. "Robust Speech Recognition via Large-Scale Weak Supervision." arXiv:2212.04356v1 [eess.AS], Dezember 2022. Gemessenes Modell: openai/whisper-large-v3, Lizenz Apache-2.0.
[7] X. Shi, X. Wang, Z. Guo, Y. Wang, P. Zhang u. a. (Qwen Team, Alibaba). "Qwen3-ASR Technical Report." arXiv:2601.21337v2 [cs.CL], Januar 2026. Gemessenes Modell: Qwen/Qwen3-ASR-1.7B, Lizenz Apache-2.0.
[8] ElevenLabs. "Scribe v2 Medical is now available to everyone." Blogbeitrag vom 22. September 2026, zuletzt aktualisiert am 27. September 2026. https://elevenlabs.io/blog/scribe-v2-medical-generally-available
Abbildungen herunterladen
Alle vier Abbildungen auf Deutsch und Englisch, als PNG (200 dpi) oder SVG (Vektor). Vor dem Speichern fragt der Browser nach.
| Abbildung 1: Diktatbeispiel | Deutsch · PNG Deutsch · SVG Englisch · PNG Englisch · SVG |
|---|---|
| Abbildung 2: Wortfehlerrate MedTerm | Deutsch · PNG Deutsch · SVG Englisch · PNG Englisch · SVG |
| Abbildung 3: Vokabular-Funktion | Deutsch · PNG Deutsch · SVG Englisch · PNG Englisch · SVG |
| Abbildung 4: Wortfehlerrate MedDictate | Deutsch · PNG Deutsch · SVG Englisch · PNG Englisch · SVG |
Über die Autoren
Leo Harmsen
Team Lead Development, IDM gGmbH
Softwareentwickler und Team Lead Development im ORPHEUS-Team der IDM.
LinkedIn →